
یک بافر را چه کسی کپی کند؟
فرض کنید 256 نمونهٔ 32 بیتی در یک آرایه داریم و میخواهیم همان دادهها را در آرایهٔ دیگری قرار دهیم. روش اول، فراخوانی memcpy است؛ پردازنده دستورهای کپی را اجرا میکند. روش دوم، سپردن نشانیها و تعداد دادهها به یک واحد سختافزاری به نام DMA است. در این روش لازم نیست هسته برای هر داده، دستور بارگذاری و ذخیرهٔ جدا اجرا کند.
پیشنیاز، درس 10؛ وقفه و NVIC است. نمونه روی STM32F303CBT6 و برد GB100ST V2.0 آماده شده است. پروژه بدون هشدار کامپایل شده؛ اجرای روی برد و اندازهگیری سرعت انتقال هنوز انجام نشدهاند.
هدف، ساخت یک کپی درست و سپس مقایسهٔ منصفانهٔ زمانهاست. DMA همیشه سریعتر نیست و استفاده از آن به معنی مصرف صفر پردازنده نیست. پردازنده تنظیم، شروع و رسیدگی پایان کار را انجام میدهد؛ اگر منتظر پایان در حلقه بماند، همان انتظار هم هسته را مشغول میکند. وقفهها نیز میتوانند اجرای یک کپی پردازنده را قطع کنند؛ عبارت «پردازنده هیچ رخدادی را پاسخ نمیدهد» درست نیست.
DMA به کدام حافظه دسترسی دارد؟
DMA کوتاهشدهٔ Direct Memory Access، یعنی دسترسی مستقیم به حافظه است. CPU و DMA از مسیرهای داخلی تراشه به منابعی مانند SRAM دسترسی دارند. ماتریس گذرگاه مسیر این ارتباطهاست؛ با دسترسی به منابع مشترک، رقابت و تأخیر ممکن است ایجاد شود. داشتن DMA تضمین نمیکند همهٔ دسترسیهای CPU و DMA همزمان و بدون انتظار انجام شوند.
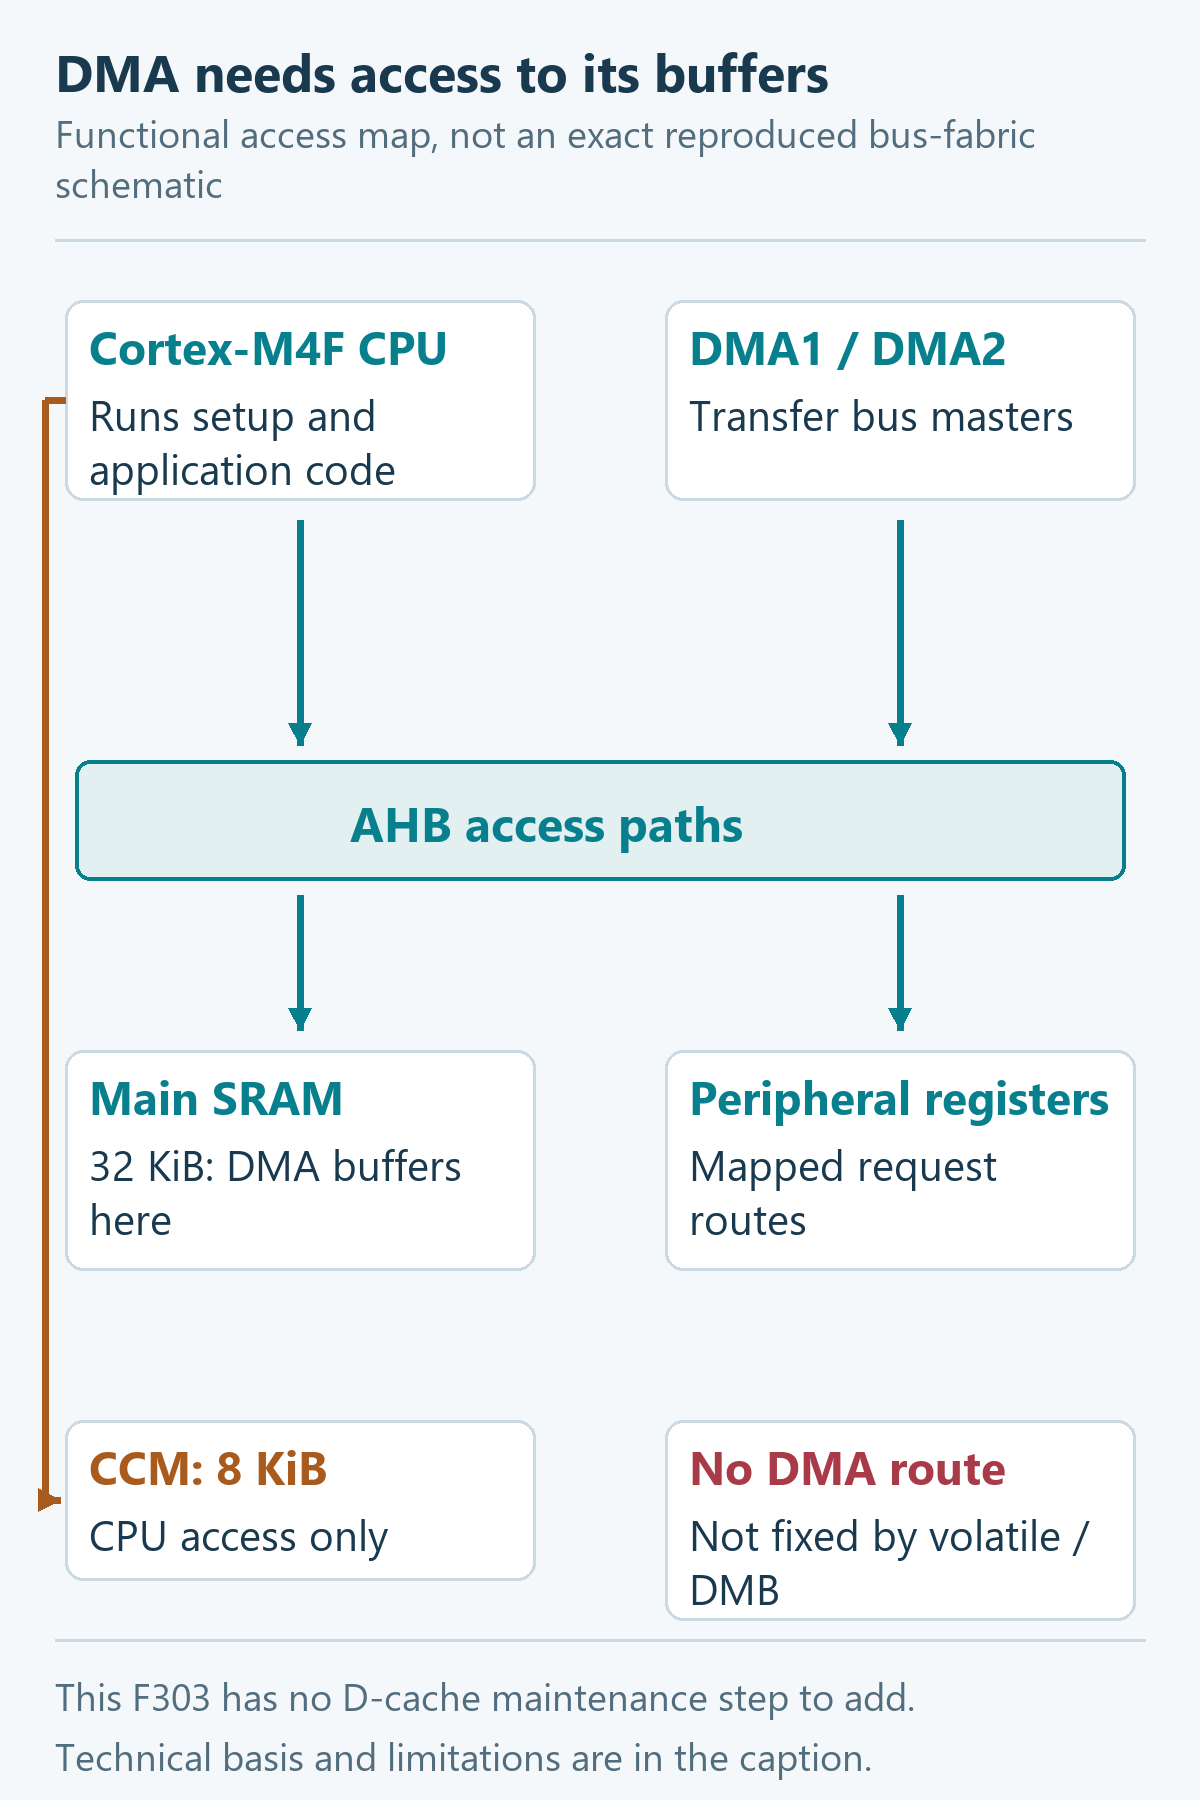
در قطعهٔ CB، Flash برابر 128 KiB، SRAM اصلی برابر 32 KiB و CCM برابر 8 KiB است؛ هر KiB برابر 1024 بایت است. CCM ناحیهای جدا برای دسترسی هسته است و DMA این تراشه به آن مسیر ندارد. محل بافر را در گزارش لینک و ELF بررسی کنید؛ تغییر volatile یا افزودن دستور سد حافظه، مسیر سختافزاری تازهای ایجاد نمیکند.
CCM: 0x10000000 … 0x10001FFF
This exercise: source and both destinations in main SRAM
در این تمرین هر 3 آرایه در SRAM اصلی قرار دارند. این انتخاب را به قانون «DMA فقط از SRAM میخواند» تبدیل نکنید؛ منابع قابل دسترسی دیگر باید از نقشهٔ همان تراشه بررسی شوند. این STM32F303 کش داده ندارد؛ دستور DMB که ترتیب دسترسیها را مشخص میکند، جای عملیات نگهداری کش در تراشههای دیگر نیست.
کانال و درخواست انتقال را بشناسیم
DMA1 دارای 7 کانال و DMA2 دارای 5 کانال است. هر کانال تنظیم نشانیها، شمارنده و اولویت خود را دارد؛ این به معنی 12 انتقال همزمان بدون رقابت روی گذرگاه نیست. درخواستِ یک پریفرال، مانند آمادهشدن دادهٔ ADC، به کانالهای تعیینشده در جدول RM0316 وصل میشود.
برای نمونه، در نگاشت پیشفرض مرتبط، ADC1 از DMA1 Channel 1 و USART1_TX از DMA1 Channel 4 استفاده میکنند. جدول و گزینههای نگاشت همان قطعه را بررسی کنید؛ چند منبعِ نگاشتشده به یک کانال، صفهای مستقل نیستند. این قطعه واحد عمومی DMAMUX برای انتخاب آزاد هر درخواست ندارد.
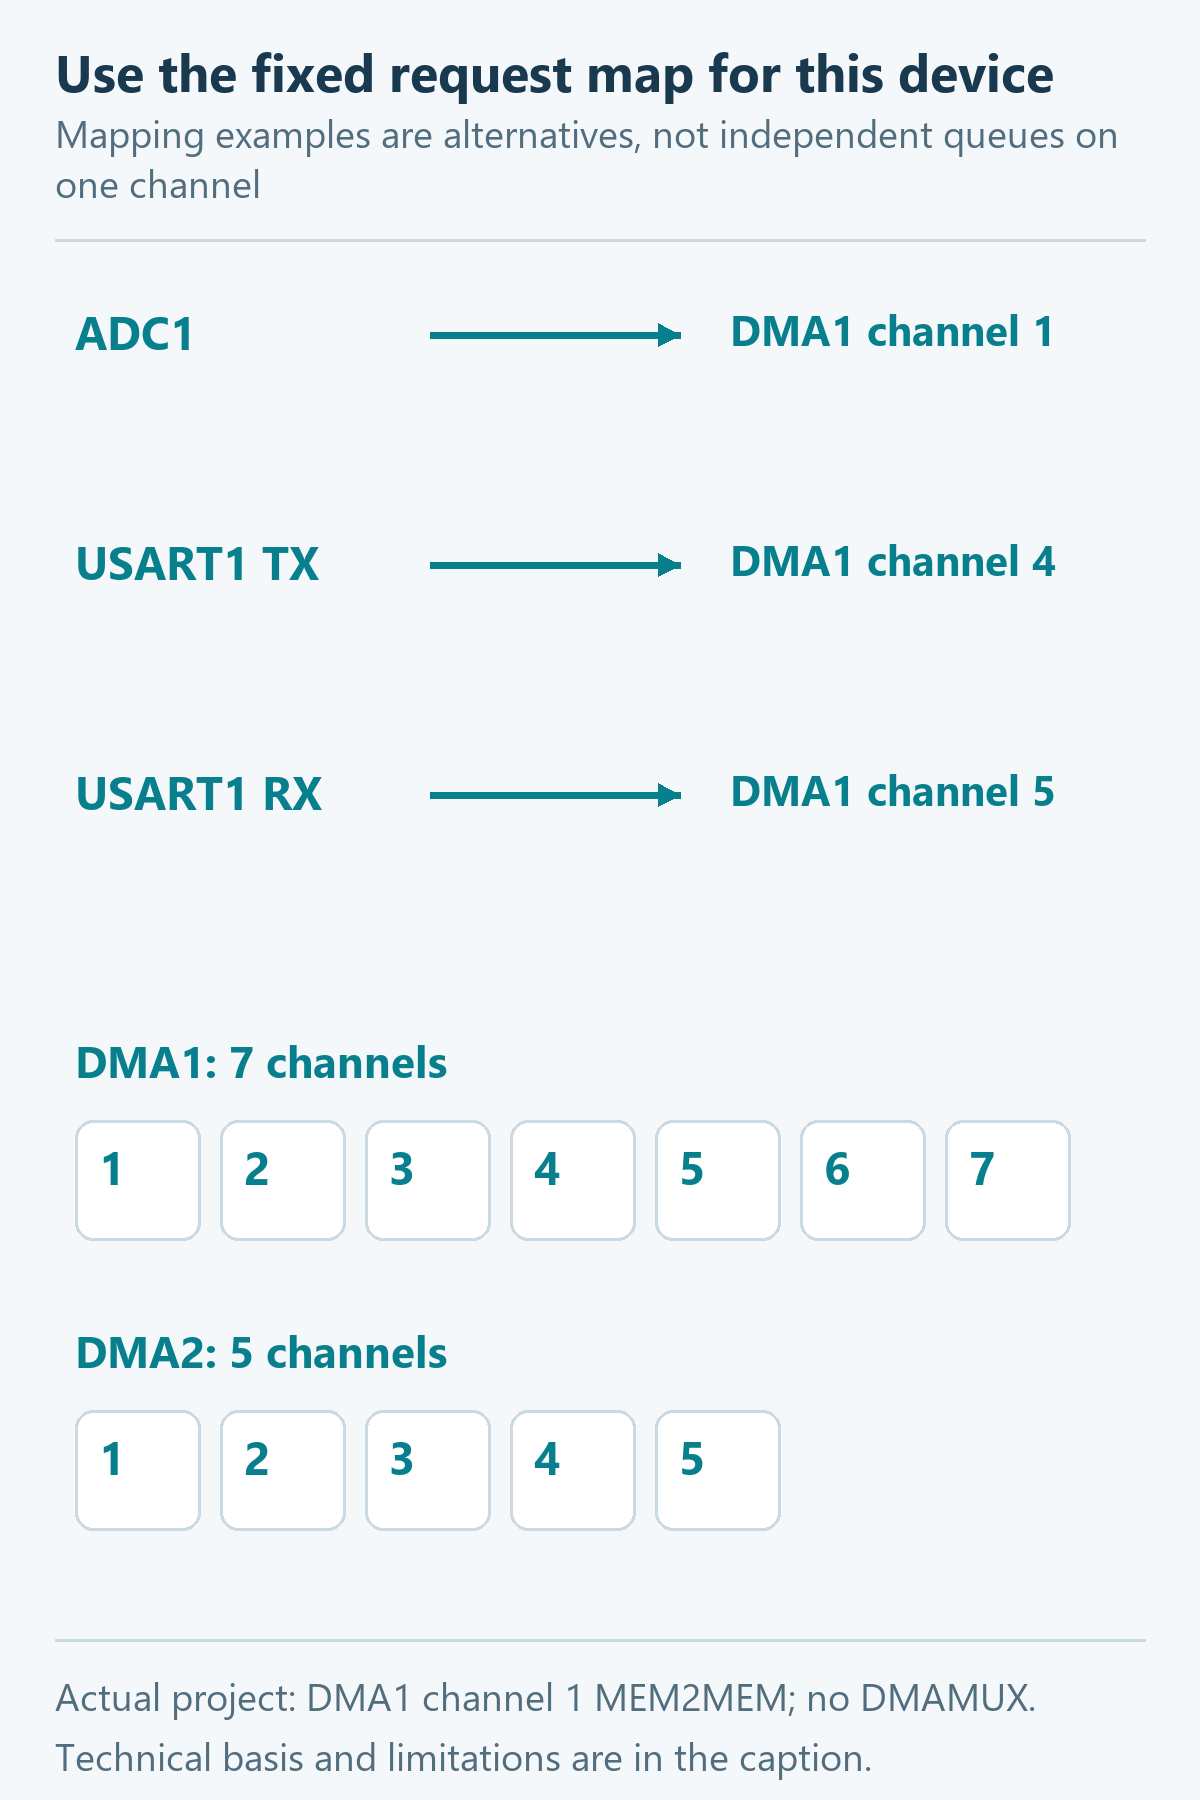
در کپی حافظه به حافظه، پریفرال داده تولید نمیکند. پس از آمادهکردن کانال، فعالسازی نرمافزاری انتقال را شروع میکند. آزمایش این درس از DMA1 Channel 1 در همین حالت استفاده میکند؛ لازم نیست UART یا ADC را برای اجرای آن راهاندازی کنید.
جهت، عرض و تعداد داده را تنظیم کنیم
جهت انتقال مشخص میکند داده از حافظه به پریفرال، از پریفرال به حافظه، یا بین دو محدودهٔ حافظه میرود. عرض داده یعنی اندازهٔ هر واحد انتقال: Byte برابر 1 بایت، Half-Word برابر 2 بایت و Word برابر 4 بایت. در این پروژه عرض هر دو طرف Word است و هر دو نشانی بعد از هر داده، 4 بایت جلو میروند.
Bytes per word = 4
Total = 256 × 4 = 1024 bytes
Half transfer = 128 words = 512 bytes
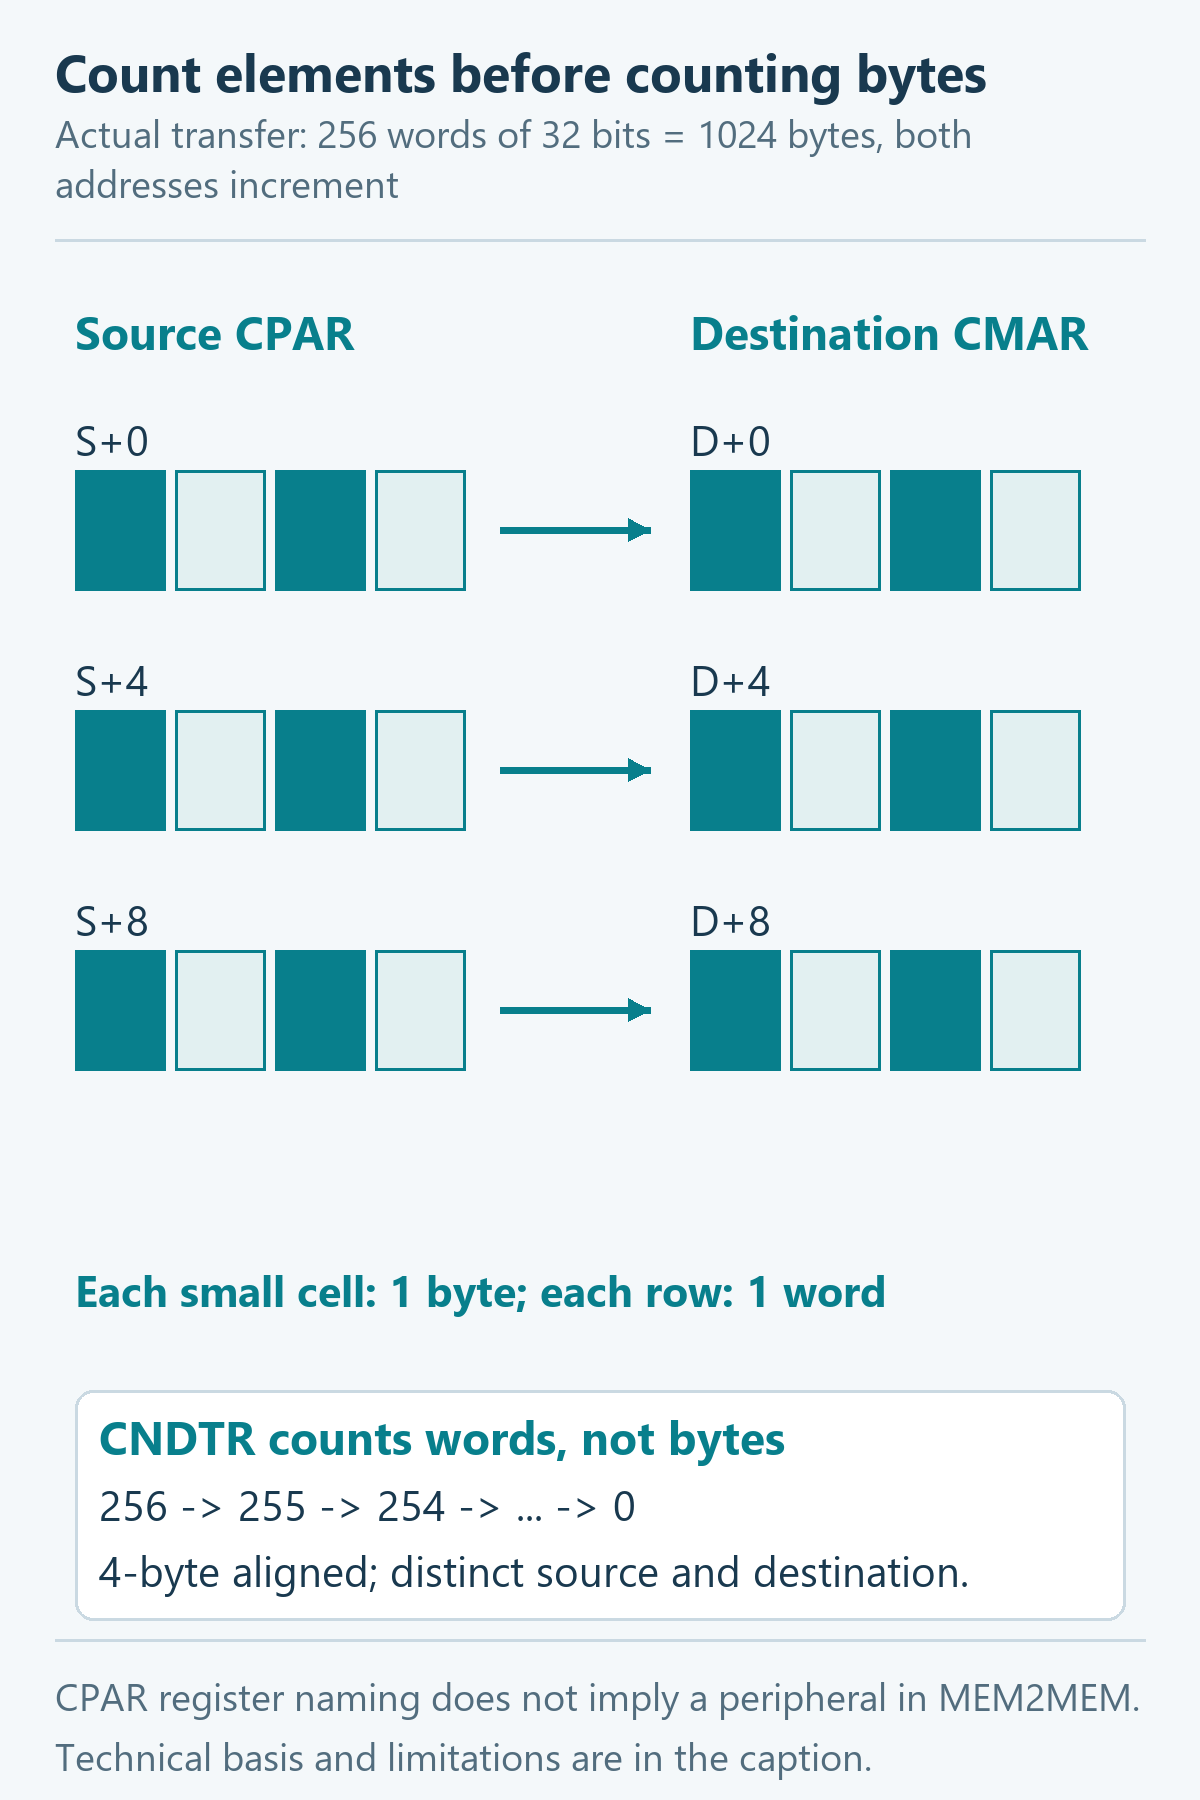
ثبات CNDTR تعداد واحدهای انتقال را میشمارد، نه همیشه تعداد بایتها را. برای بافر 1024 بایتی این نمونه، عدد درست 256 است. تنظیم اشتباه 1024 با عرض Word میتواند نوشتن را از انتهای بافر عبور دهد. نشانیها نیز باید با عرض انتخابی همتراز باشند؛ آرایههای uint32_t این پروژه در ELF روی مرز 4 بایتی قرار گرفتهاند.
در این جهت، HAL نشانی مبدأ را در CPAR و مقصد را در CMAR قرار میدهد. وجود واژهٔ Periph در نام یک ثبات یا گزینه، به معنی پریفرالبودن واقعی مبدأ کپی حافظه به حافظه نیست. PINC و MINC در این نمونه هر دو فعالاند؛ هنگام انتقال به یک ثبات دادهٔ ثابت، افزایش همان سمت معمولاً غیرفعال میشود.
Normal با Circular چه تفاوتی دارد؟
در Normal، پس از تمامشدن تعداد تعیینشده، جریان این انتقال پایان مییابد و برای کار بعدی باید وضعیت و تنظیم شروع دوباره آماده باشند. در Circular، شمارنده و نشانیهای مربوط برای دور بعد بازبارگذاری میشوند؛ ادامهٔ جابهجایی به درخواستها و تنظیمهای همان کاربرد هم وابسته است.
طبق RM0316، ترکیب MEM2MEM و Circular در این کنترلر پشتیبانی نمیشود؛ CIRC را در این تمرین خاموش نگه دارید. تنظیم نامعتبر را به امید دیدن حتمی TE آزمایش نکنید. کاربرد حلقویِ دریافت پیوسته، موضوعی متفاوت از این کپی تکمرحلهای است.
اولویت کانال با اولویت وقفه یکی نیست
سطحهای Low، Medium، High و Very High ترتیب خدمت کانالهای همان کنترلر DMA را تعیین میکنند. در اولویت برابر، شمارهٔ کانال کوچکتر تقدم دارد. این داوری محلی را با اولویت وقفهٔ CPU یا مالکیت کامل گذرگاه یکی ندانید؛ رقابت بر سر حافظه و منابع مشترک همچنان اثر دارد. در این نمونه اولویت کانال High و اولویت وقفهٔ NVIC برابر 2 است.
از پرچم انتقال به callback برسیم
HT یعنی رسیدن به نیمهٔ انتقال، TC یعنی تکمیل تعداد تعیینشده و TE یعنی خطای انتقال. پرچمها در ثبات DMA_ISR ثبت میشوند. با فعالبودن وقفهٔ متناظر و شرایط ورود CPU، رسیدگی وقفه انجام میشود؛ زمان رسیدن callback با لحظهٔ دقیق آخرین نوشتن روی گذرگاه یکی نیست.
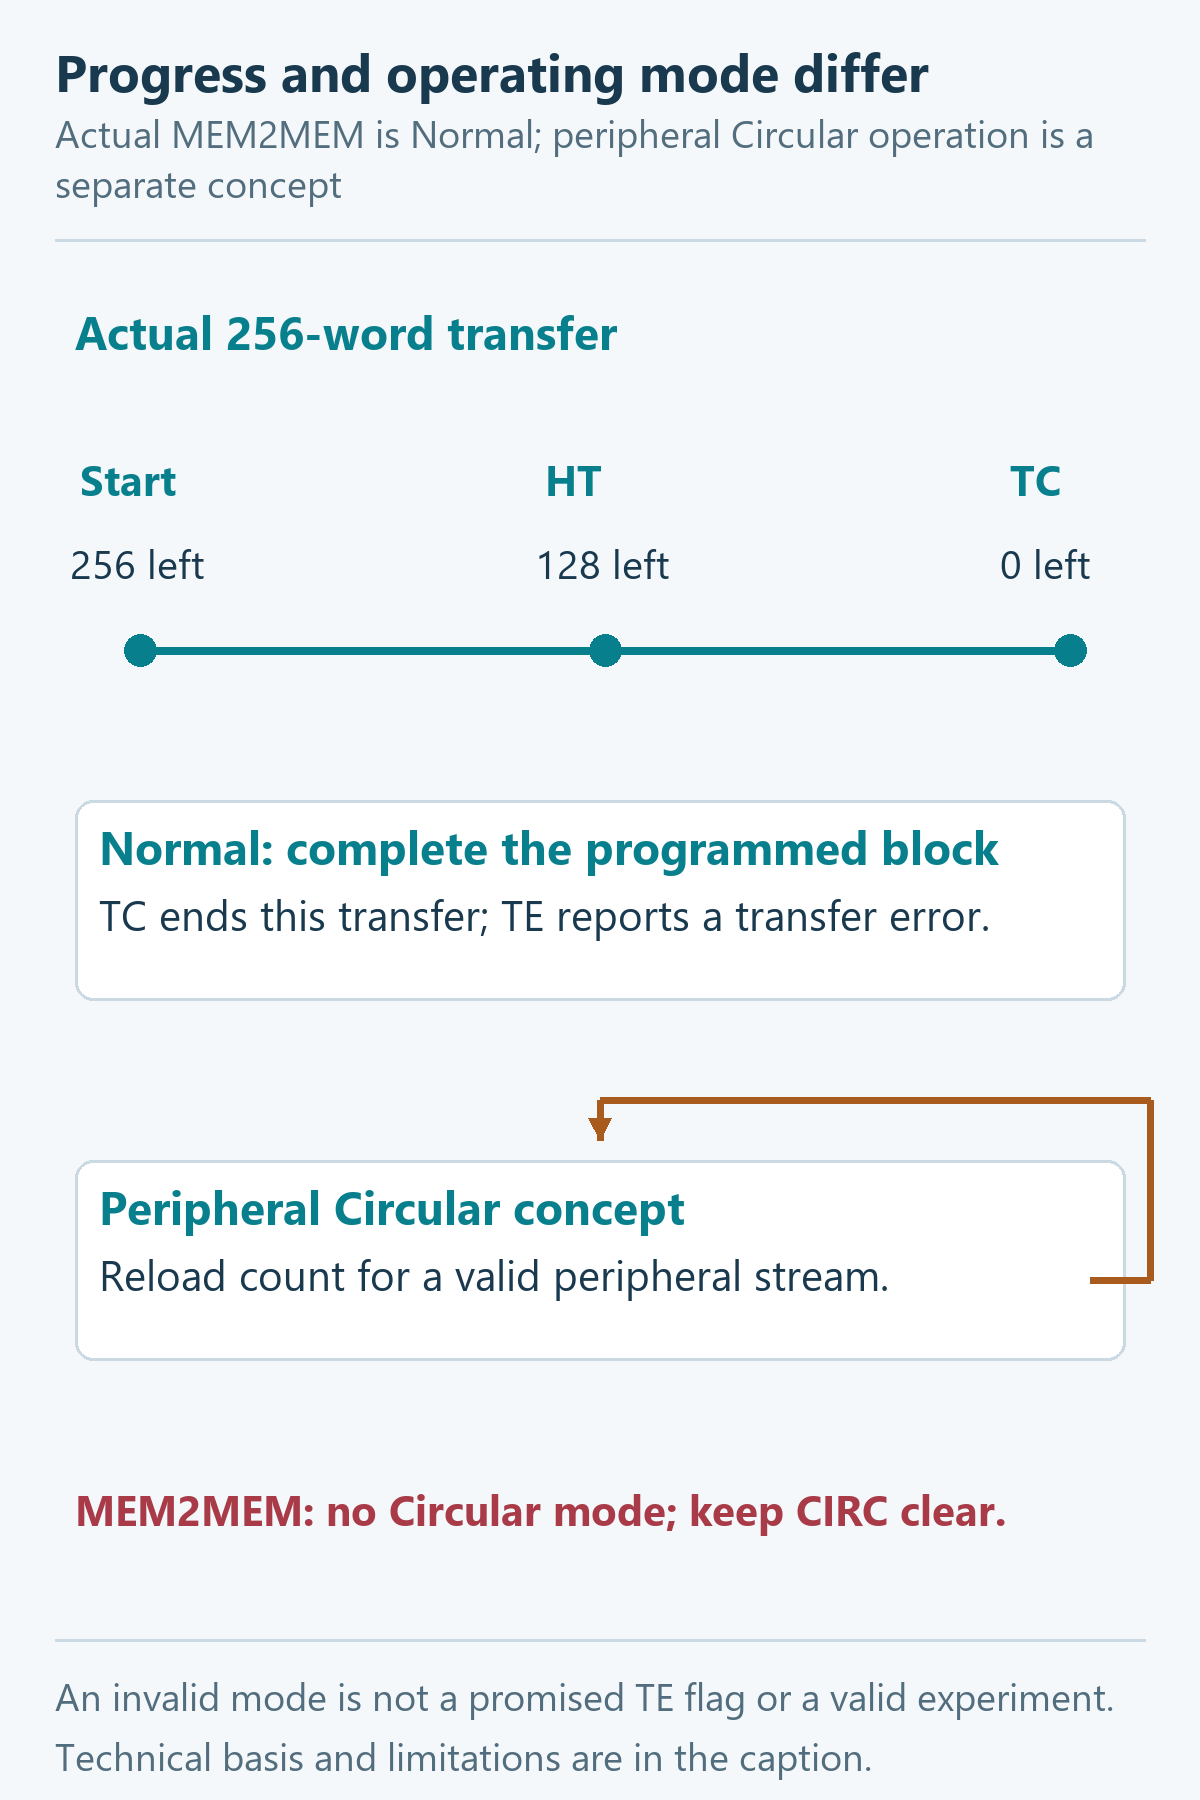
در این پروژه، DMA1_Channel1_IRQHandler تابع HAL_DMA_IRQHandler را صدا میزند. HAL پرچم مربوط را با نوشتن در IFCR پاک و callback ثبتشده را اجرا میکند. این پرچمها صف نامحدود رخداد نیستند. HT در جریانهای پیوسته میتواند برای تحویل نیمهٔ بافر مفید باشد، اما فقط با مالکیت روشن داده و پایان پردازش پیش از استفادهٔ دوبارهٔ سختافزار؛ خود پرچم، نبود رقابت را تضمین نمیکند.
در USER CODE 2 هر 3 callback مربوط به HT، TC و TE ثبت شدهاند. در HAL همین نسخه، غیرتهیبودن callback نیمهانتقال باعث فعالشدن وقفهٔ HT هنگام Start_IT میشود؛ آن را نتیجهٔ همیشگی هر فراخوانی Start_IT ندانید. در callback پایان این نمونه، ابتدا زمان نسبی ثبت و سپس dma_done برابر 1 میشود. مقدار زمان صفر هم یک نتیجهٔ عددی ممکن است؛ به همین دلیل، پرچم مستقل پایان را با «زمان غیرصفر» جایگزین نکردهایم. TE شمارنده و پرچم خطا را تغییر میدهد؛ هیچ خطای عمدی روی برد ایجاد نشده است.
پروژهٔ واقعی را مرحلهبهمرحله دنبال کنیم
بسته را استخراج و README را بخوانید. خروجیِ بررسیشده CMake است؛ واردکردن و ساخت بومی CubeIDE اینجا آزمایش نشده است. کلاک پایهٔ درس 9، یعنی HSE با مقدار اسمی 8 MHz و PLL ضرب 9، حفظ شده: HCLK برابر 72 MHz، APB1 برابر 36 MHz، APB2 برابر 72 MHz و Flash دارای 2 حالت انتظار است. SWD نیز حفظ شده است.
در CubeMX، DMA1 Channel 1 را Memory to Memory، هر دو عرض را Word، افزایش هر دو نشانی را فعال، حالت را Normal و وقفه را فعال کنید. تابع زیر عین خروجی تولیدشدهٔ Core/Src/dma.c است؛ برای مطالعه آمده و نباید آن را دوباره در main.c تعریف کنید.
void MX_DMA_Init(void)
{

  /* DMA controller clock enable */
  __HAL_RCC_DMA1_CLK_ENABLE();

  /* Configure DMA request hdma_memtomem_dma1_channel1 on DMA1_Channel1 */
  hdma_memtomem_dma1_channel1.Instance = DMA1_Channel1;
  hdma_memtomem_dma1_channel1.Init.Direction = DMA_MEMORY_TO_MEMORY;
  hdma_memtomem_dma1_channel1.Init.PeriphInc = DMA_PINC_ENABLE;
  hdma_memtomem_dma1_channel1.Init.MemInc = DMA_MINC_ENABLE;
  hdma_memtomem_dma1_channel1.Init.PeriphDataAlignment = DMA_PDATAALIGN_WORD;
  hdma_memtomem_dma1_channel1.Init.MemDataAlignment = DMA_MDATAALIGN_WORD;
  hdma_memtomem_dma1_channel1.Init.Mode = DMA_NORMAL;
  hdma_memtomem_dma1_channel1.Init.Priority = DMA_PRIORITY_HIGH;
  if (HAL_DMA_Init(&hdma_memtomem_dma1_channel1) != HAL_OK)
  {
    Error_Handler();
  }

  /* DMA interrupt init */
  /* DMA1_Channel1_IRQn interrupt configuration */
  HAL_NVIC_SetPriority(DMA1_Channel1_IRQn, 2, 0);
  HAL_NVIC_EnableIRQ(DMA1_Channel1_IRQn);

}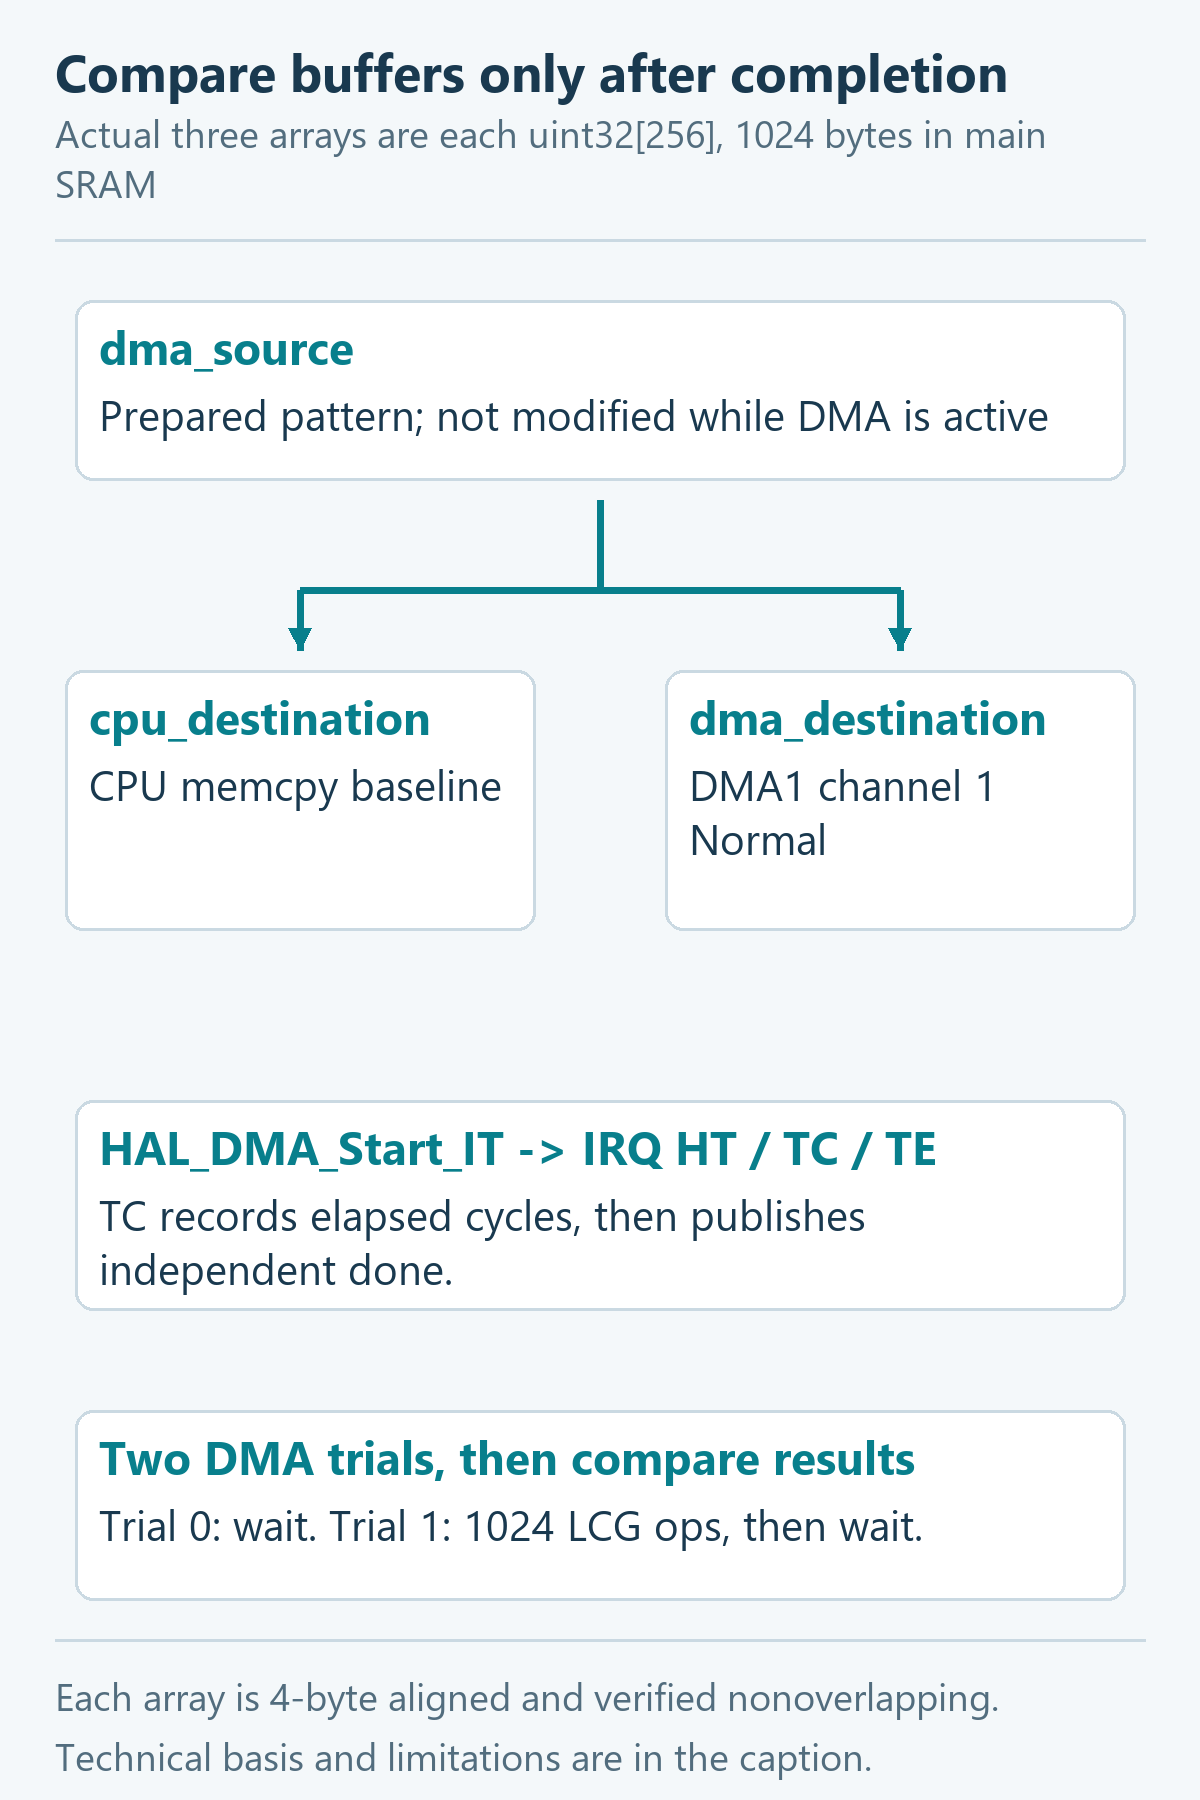
برنامه در USER CODE 2، یک بار پس از راهاندازی اجرا میشود و سپس حلقهٔ اصلی خالی است. 3 آرایهٔ 256 عضوی به نامهای dma_source، cpu_destination و dma_destination داریم. الگوی مبدأ پر میشود؛ memcpy کپی CPU را میسازد، سپس دو نوبت کپی DMA انجام میشود. بین دو نوبت مقصد پاک و پس از تکمیل با memcmp مقایسه میشود. مقصدها با یکدیگر و مبدأ همپوشانی ندارند.
نوبت 0 بعد از شروع منتظر پایان میماند. نوبت 1 بعد از شروع، 1024 مرحلهٔ محاسبه انجام میدهد و سپس اگر لازم باشد منتظر میماند. این طراحی فرصت اجرای کار دیگر را نشان میدهد؛ کپی کوچک ممکن است پیش از شروع آن محاسبه تمام شده باشد. بدون شاهد زمانبندی، همپوشانی واقعی را نتیجه نمیگیریم.
گزیدهٔ زیر از ابتدای Run_Dma در USER CODE 4 فایل main.c است. این کد به آرایهها، handle، callbackها و مقداردهی کامل پروژه وابسته است؛ برنامهٔ مستقل یا تابع تکراری نسازید.
dma_done = 0U;
  dma_error = 0U;
  dma_elapsed_at_callback = 0U;
  __DMB();
  transfer_start_cycle = DWT->CYCCNT;
  if (HAL_DMA_Start_IT(&hdma_memtomem_dma1_channel1, (uint32_t)dma_source,
                       (uint32_t)dma_destination, COPY_WORDS) != HAL_OK)
  { Error_Handler(); }
  dma_start_cycles[trial] = DWT->CYCCNT - transfer_start_cycle;
در مدت انتقال، CPU مبدأ را تغییر نمیدهد و نتیجهٔ مقصد را پس از اعلام پایان میخواند. ادامهٔ Run_Dma با پرچمهای dma_done و dma_error انتظار را کنترل میکند. مهلت تنظیمشده 100 ms از شروع بخش انتظار محاسبه میشود؛ در نوبت دارای کار پیشزمینه، این مهلت بعد از آن کار آغاز میشود، پس سقف سخت 100 ms برای کل تابع نیست. پایش مهلت با HAL_GetTick انجام میشود؛ اگر تیک SysTick پیش نرود، خروجِ مبتنی بر پایان مهلت تضمین نمیشود. خروج موفق با پرچم dma_done مسیر جداگانهای است.
گزیدهٔ کامل callback پایان از همان USER CODE 4:
static void Transfer_Complete(DMA_HandleTypeDef *hdma)
{
  if (hdma == &hdma_memtomem_dma1_channel1)
  {
    dma_tc_callbacks++;
    __DMB();
    dma_elapsed_at_callback = DWT->CYCCNT - transfer_start_cycle;
    __DMB();
    dma_done = 1U;
  }
}
پس از مقایسهها، benchmark_complete برابر 1 میشود. اگر memory_mismatches صفر باشد، فرمان High به PB6 داده میشود؛ مدار NPN برد نشانگر کاربر را روشن میکند. این رفتار مورد انتظارِ سورس است؛ روشنشدن LED یا صفرماندن شمارنده روی برد اینجا مشاهده نشده است.
چه زمانی را با چه زمانی مقایسه کنیم؟
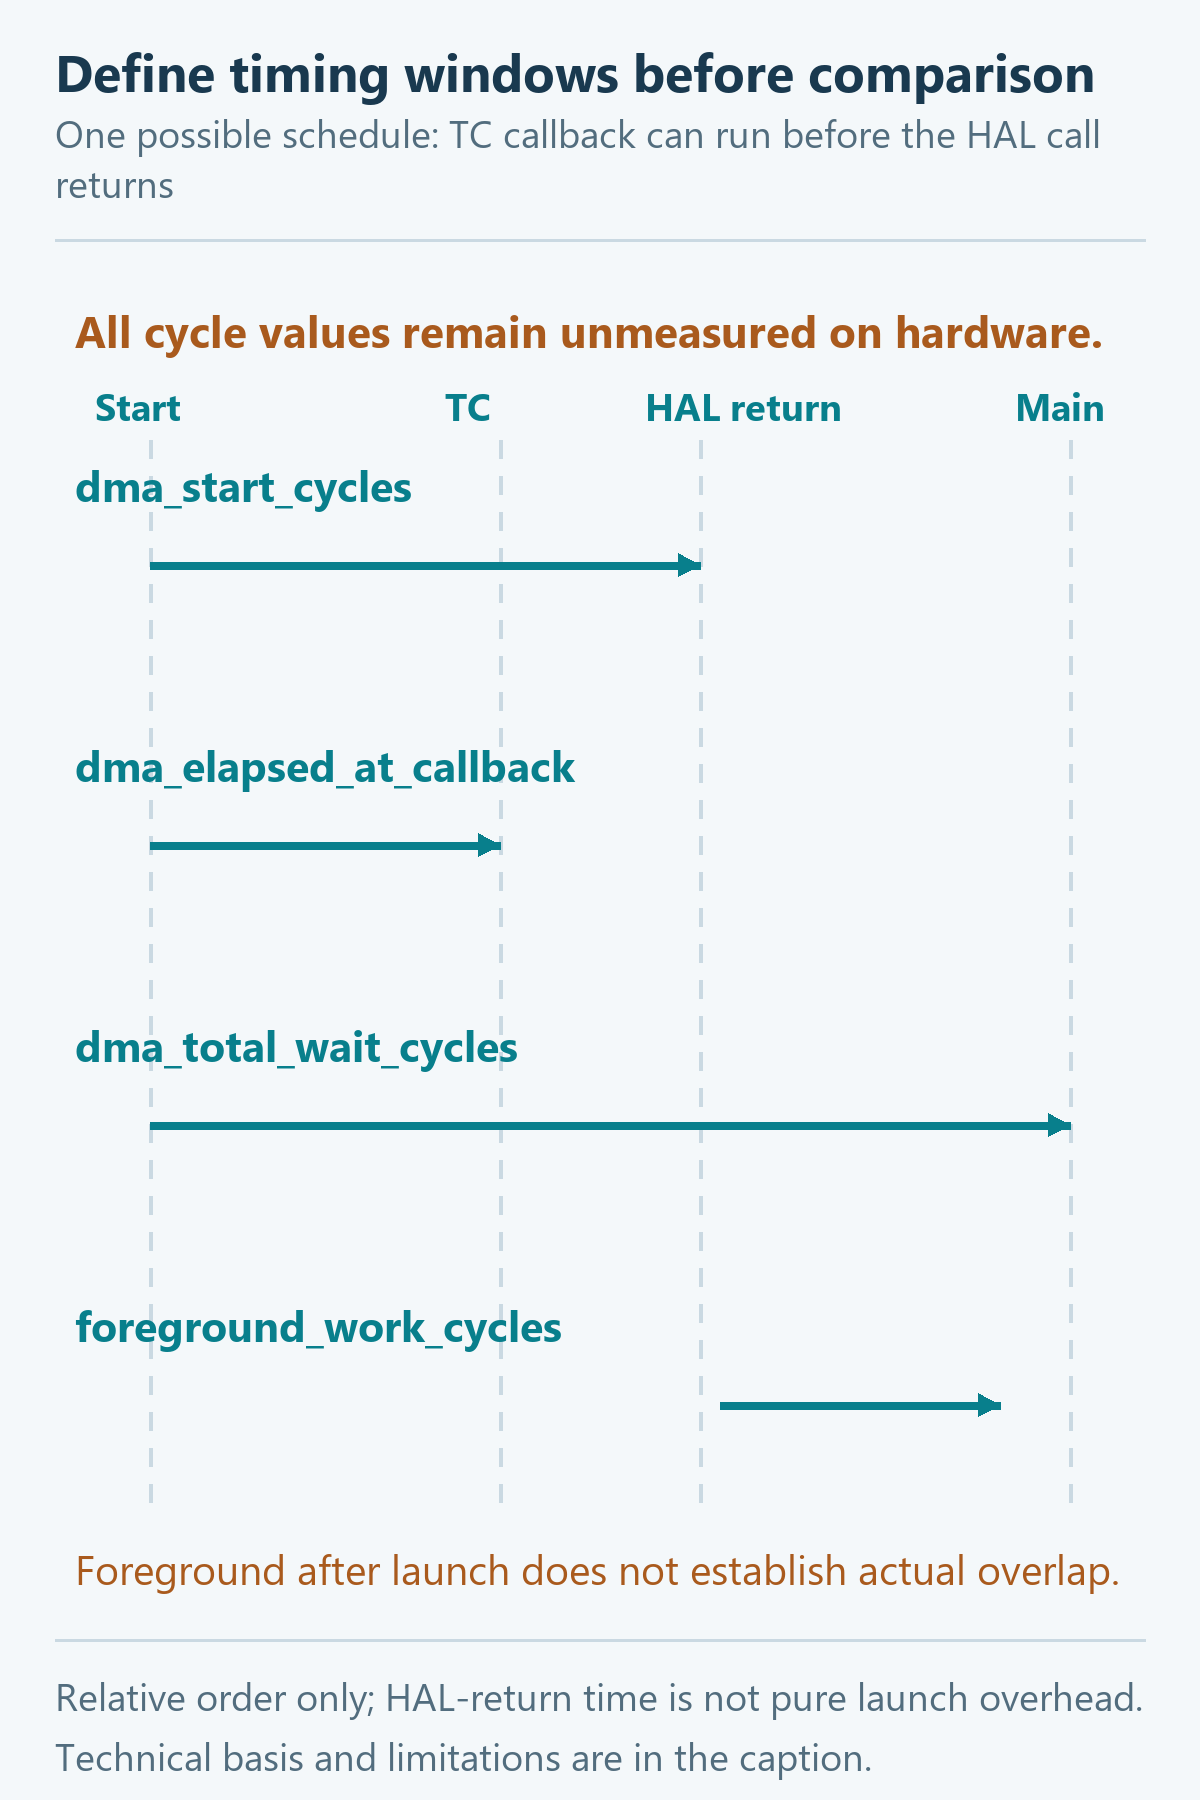
DWT یک واحد هسته است که شمارندهٔ چرخهٔ CYCCNT را در اختیار برنامه میگذارد. در کلاک نامی 72 MHz، هر چرخه حدود 13.8889 ns است. این تبدیل واحد، زمان واقعی کپی را پیشبینی نمیکند؛ برای آن باید مقدار شمارنده در اجرای واقعی ثبت شود.
Elapsed cycles = (uint32_t)(end – start)
| متغیر | بازهٔ ثبتشده در همین کد | چه چیزی را ثابت نمیکند؟ |
|---|---|---|
| cpu_copy_cycles | خواندن شمارنده، memcpy، DMB و خواندن بعدی | زمان خالص هر دستور؛ سربار اندازهگیری و وقفهها هم اثر دارند |
| dma_start_cycles | از قبلِ فراخوانی شروع تا بازگشت HAL | هزینهٔ خالص راهاندازی؛ ممکن است وقفهٔ پایان هم بین این دو نقطه اجرا شود |
| dma_callback_cycles | از شروع تا ثبت داخل callback پایان | زمان خالص انتقال روی گذرگاه؛ تأخیر رسیدگی وقفه هم در آن است |
| dma_total_wait_cycles | از شروع تا ثبت CYCCNT پس از انتظار در Run_Dma | راهاندازی، کار پیشزمینه و انتظار احتمالی باقیمانده را شامل میشود؛ تمام آن زمان انتظار چرخشی نیست |
برای مقایسه، تعداد و محتوای داده، همترازی، سطح بهینهسازی، وضعیت وقفهها و تعریف نقطهٔ پایان را یکسان و ثبت کنید. کد کتابخانهای memcpy ممکن است تنظیمهای ساخت خودش را داشته باشد؛ O0 بودن main به معنی O0 بودن آن کتابخانه نیست. یک دور اندازهگیری نیز جای تکرار و بررسی پراکندگی را نمیگیرد.
برای حجم کم ممکن است هزینهٔ شروع و رسیدگی DMA از کپی CPU بیشتر شود؛ برای کاربردی دیگر، فرصت اجرای کار مستقل مهمتر است. هیچ مرز عمومی مانند «از 30 بایت به بالا» یا درصد افزایش سرعت در این درس نداریم. انتظار چرخشی در نوبت 0 هسته را مشغول میکند و مقایسهٔ زمان بهتنهایی اندازهگیری درصد بار CPU نیست.
اگر نتیجه درست نبود، از کجا بررسی کنیم؟
| نشانه | بررسی بعدی |
|---|---|
| دادهها برابر نیستند | تعداد را به واحد Word بخوانید؛ طول، عرض، افزایش نشانی و نداشتن همپوشانی را بررسی کنید |
| آرایه در CCM قرار گرفته | از ELF/MAP محل را اصلاح کنید؛ DMA به این ناحیه دسترسی ندارد و این مسیر معتبر نیست |
| callback دیده نمیشود | کلاک DMA، فعالبودن IRQ و مسیر handler به HAL، ثبت callback و پرچمها را بررسی کنید |
| انتظار تمام نمیشود | پیشروی تیک و پرچمهای پایان/خطا را بررسی کنید؛ توقف دیباگ روی زمان اثر دارد |
| عدد زمان غیرمنتظره است | مرز اندازهگیری، وقفهها، ساخت و نوبت دارای کار را تطبیق دهید؛ آن را فوراً سرعت واقعی باس ننامید |
حافظهٔ نامعتبر یا تنظیم ممنوع را برای گرفتن یک نوع خطای تضمینی امتحان نکنید. در خطای شروع، TE یا پایان مهلت، پروژه مسیر Error_Handler را دارد؛ LED خاموش بهتنهایی علت توقف یا خرابی سختافزار را مشخص نمیکند.
خودآزمایی با پاسخ
پرسش 1: آیا استفاده از DMA یعنی پردازنده هیچ کاری نمیکند؟
پاسخ: خیر؛ شروع، رسیدگی پایان و هر انتظار فعال هزینه دارد. DMA دستورهای کپیِ تکتک دادهها را از هسته برمیدارد.
پرسش 2: برای 1024 بایت با عرض Word، CNDTR چند است؟
پاسخ: 256؛ هر Word برابر 4 بایت است. عرض و ظرفیت هر دو بافر باید همین انتخاب را پشتیبانی کنند.
پرسش 3: آیا volatile بافر CCM را برای DMA قابل دسترسی میکند؟
پاسخ: خیر؛ این محدودیت مسیر سختافزاری است. بافرهای این تمرین در SRAM اصلی قرار دارند.
پرسش 4: اولویت High کانال با اولویت 2 وقفه یک چیز است؟
پاسخ: خیر؛ اولی داوری کانالهای کنترلر DMA و دومی تقدم رسیدگی CPU را تنظیم میکند.
پرسش 5: چرا dma_start_cycles هزینهٔ خالص راهاندازی نیست؟
پاسخ: چون تا بازگشت HAL ثبت میشود و ممکن است وقفهٔ پایان نیز پیش از ثبت مقدار اجرا شده باشد.
پرسش 6: آیا رسیدن HT همیشه اجازهٔ پردازش بدون تداخل نیمهٔ بافر است؟
پاسخ: خیر؛ مالکیت داده، جهت انتقال و زمان استفادهٔ دوباره باید مشخص باشند. پرچم بهتنهایی هماهنگی را تضمین نمیکند.
3 تمرین
- پایه: برای 512 بایت با عرض Half-Word، تعداد انتقال و تعداد داده در نیمه را حساب کنید. پاسخ 256 و 128 واحد است. توضیح دهید چرا از این شمارش نمیتوان زمان واقعی را با فرض «هر انتقال فقط 1 چرخه» نتیجه گرفت.
- میانی: مدل verify_model.py و محاسبهٔ calculate_clock.py را اجرا کنید. آدرس و اندازهٔ 3 آرایه را از فایل ELF همراه با ظرفیت SRAM مقایسه کنید. معیار پایان، تراز 4 بایتی، اندازهٔ 1024 بایت برای هر آرایه و نبود همپوشانی است؛ این بررسی جای اجرای DMA روی برد را نمیگیرد.
- پیشرفته: با پروژهٔ کامل و پس از ساخت مجدد، دو نوبت واقعی را روی برد ثبت کنید. ابتدا برابری دادهها، سپس هر بازهٔ زمان جدول را بررسی کنید. برای اندازههای دیگر، در کپی پروژه تعداد و ظرفیت هر 3 بافر را هماهنگ تغییر دهید و دوباره بسازید. اگر برتری ثابتی دیده نشد یا همپوشانی ثابت نشد، همان را گزارش کنید؛ عدد مرجع ساختگی وجود ندارد.
وضعیت بررسی و منابع
پروژهٔ تازه با CubeMX 6.14.0، پایگاه 6.0.140 و CubeF3 V1.11.6 تولید و با GCC 13.2.1 در ساخت پاک Debug با -O0 -g3 -Wall -Werror بدون هشدار ساخته شد. Flash برابر 10832 بایت و RAM ناحیهٔ لینک برابر 4808 بایت است؛ RAM شامل رزرو heap و stack است و اوج مصرف اجرا نیست.
8 گروه بررسی مدل و فایل ELF و 2 بررسی محاسبات نامی اجرا شدهاند. سورس، IOC، مجوزها، ELF/MAP، گزارش، هشها و کاربرگ در انتظار همراهاند. هیچ چرخهٔ واقعی کپی، درصد بار پردازنده، اجرای برد، خطای عمدی یا نشست CubeIDE GUI اندازهگیری و ثبت نشده است.
مشخصات از DS9118 Rev 14، نگاشت و رفتار DMA از RM0316 و رفتار Start_IT، IRQ و callback از سورس HAL با شناسهٔ 953955a بررسی شدهاند. تعریفهای DWT/CMSIS همان بسته در منابع پروژه موجودند. شماتیک برد V2.0 مرجع PB6 و SWD است. مثال رسمی DMA_FLASHToRAM روی برد EVAL، نمونهای برای مقایسه است و عین پروژهٔ SRAM به SRAM این درس نیست.
در درس 15، ارسال و دریافت UART با DMA از همین مفاهیم برای ارتباط سریال استفاده میکنیم.
دانلود فایلهای همراه درس 14
پروژهٔ واقعی شامل IOC و سورس، خروجیهای ELF/MAP، گزارش ساخت، مدل و کاربرگ، مجوزها و 6 تصویر همراه اسکریپت قابل ویرایش در بسته قرار دارند. راهنمای پروژه وضعیت واقعی ساخت و آزمون را توضیح میدهد. ابتدا ZIP را استخراج و README را بخوانید.
پیوند دانلود به نسخهٔ مشخص و بازبینیشدهٔ همراه مقاله متصل است.