
در درس قبل، ولتاژ را هر وقت برنامه آماده بود میخواندیم. حالا میخواهیم در هر ثانیه 10000 نمونه بگیریم و آنها را دستهدسته پردازش کنیم. تایمر فاصلهٔ نمونهها را تعیین میکند، ADC ولتاژ را به عدد تبدیل میکند و DMA عددها را در حافظه میگذارد. وظیفهٔ برنامه این است که دادهٔ آماده را بهموقع و سالم تحویل بگیرد.
پیشنیازها: درس 14 ؛ DMA، درس 18 ؛ وقفهٔ تایمر و درس 22 ؛ حالتهای ADC. مثال برای STM32F303CBT6 روی GB100ST V2.0 است. مقادیر زمانی این صفحه، محاسبات اسمیاند؛ اندازهگیری برد در تهیهٔ مقاله انجام نشده است.
Polling، وقفه یا DMA؟
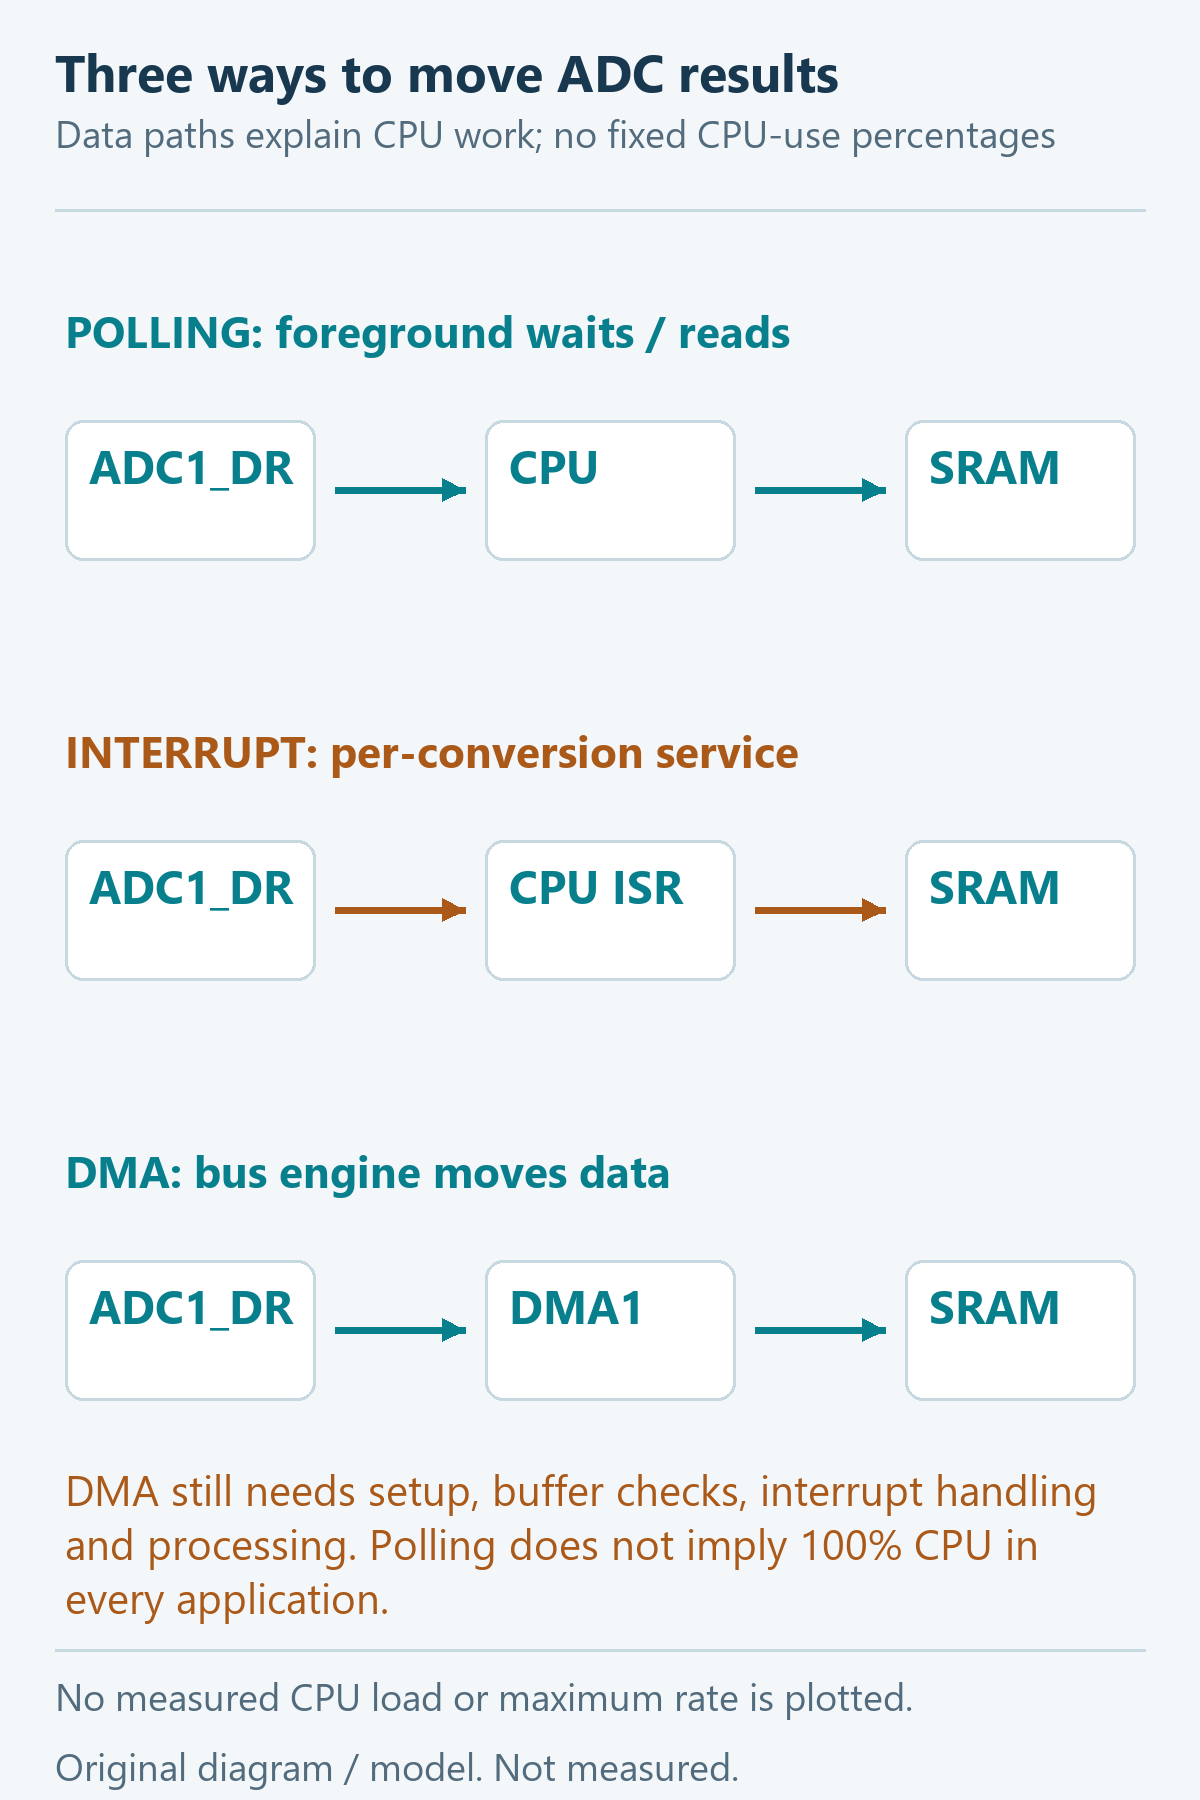
در Polling برنامه وضعیت پایان تبدیل را میپرسد و منتظر میماند. روش سادهای است و برای خواندنهای کمتعداد مناسب است؛ زمان انتظار، بخشی از وقت CPU را میگیرد. در روش وقفه، پایان تبدیل برنامه را به callback میبرد و پردازنده بین تبدیلها میتواند کار دیگری انجام دهد. ولی با هر نمونه، هزینهٔ ورود، اجرای handler و خروج از وقفه تکرار میشود.
در DMA، سختافزار نتیجه را از رجیستر دادهٔ ADC به آرایهٔ حافظه منتقل میکند. پردازنده برای جابهجایی تکتک نمونهها دستور اجرا نمیکند، اما راهاندازی، خطاها، وقفههای بلوکی و پردازش داده همچنان وقت میگیرند و DMA هم از گذرگاه حافظه استفاده میکند. درصد کاهش بار و سقف سرعت هر روش به کد و سامانه وابسته است؛ اینجا اندازهگیری نشده است.
تایمر، ساعت شروع نمونههاست
در تبدیل پیوستهٔ آزاد، ADC پس از پایان هر تبدیل، بعدی را آغاز میکند؛ نرخ به کلاک، زمان نمونهبرداری و تنظیماتی مانند AutoWait وابسته است. برای هدف مشخص 10 kS/s، در این پروژه تبدیل پیوسته خاموش و شروع هر تبدیل به رویداد تایمر سپرده شده است. این کار تغییرات زمان اجرای حلقهٔ اصلی را از زمان صدور تریگر جدا میکند. دقت مطلق همچنان به کلاک و مسیر سختافزاری بستگی دارد.
TRGO مخفف Trigger Output، رویداد داخلی خروجی تایمر است. سیم خارجی نمیخواهد. هر تایمری به هر ADC متصل نیست؛ باید منبع مجاز EXTSEL همان ADC را انتخاب کرد. در پروژهٔ واقعی، TIM3_TRGO برای ADC1 انتخاب شده است؛ TIM6 را نباید بدون بررسی جدول جایگزین آن کرد.
محاسبهٔ فاصلهٔ 100 µs
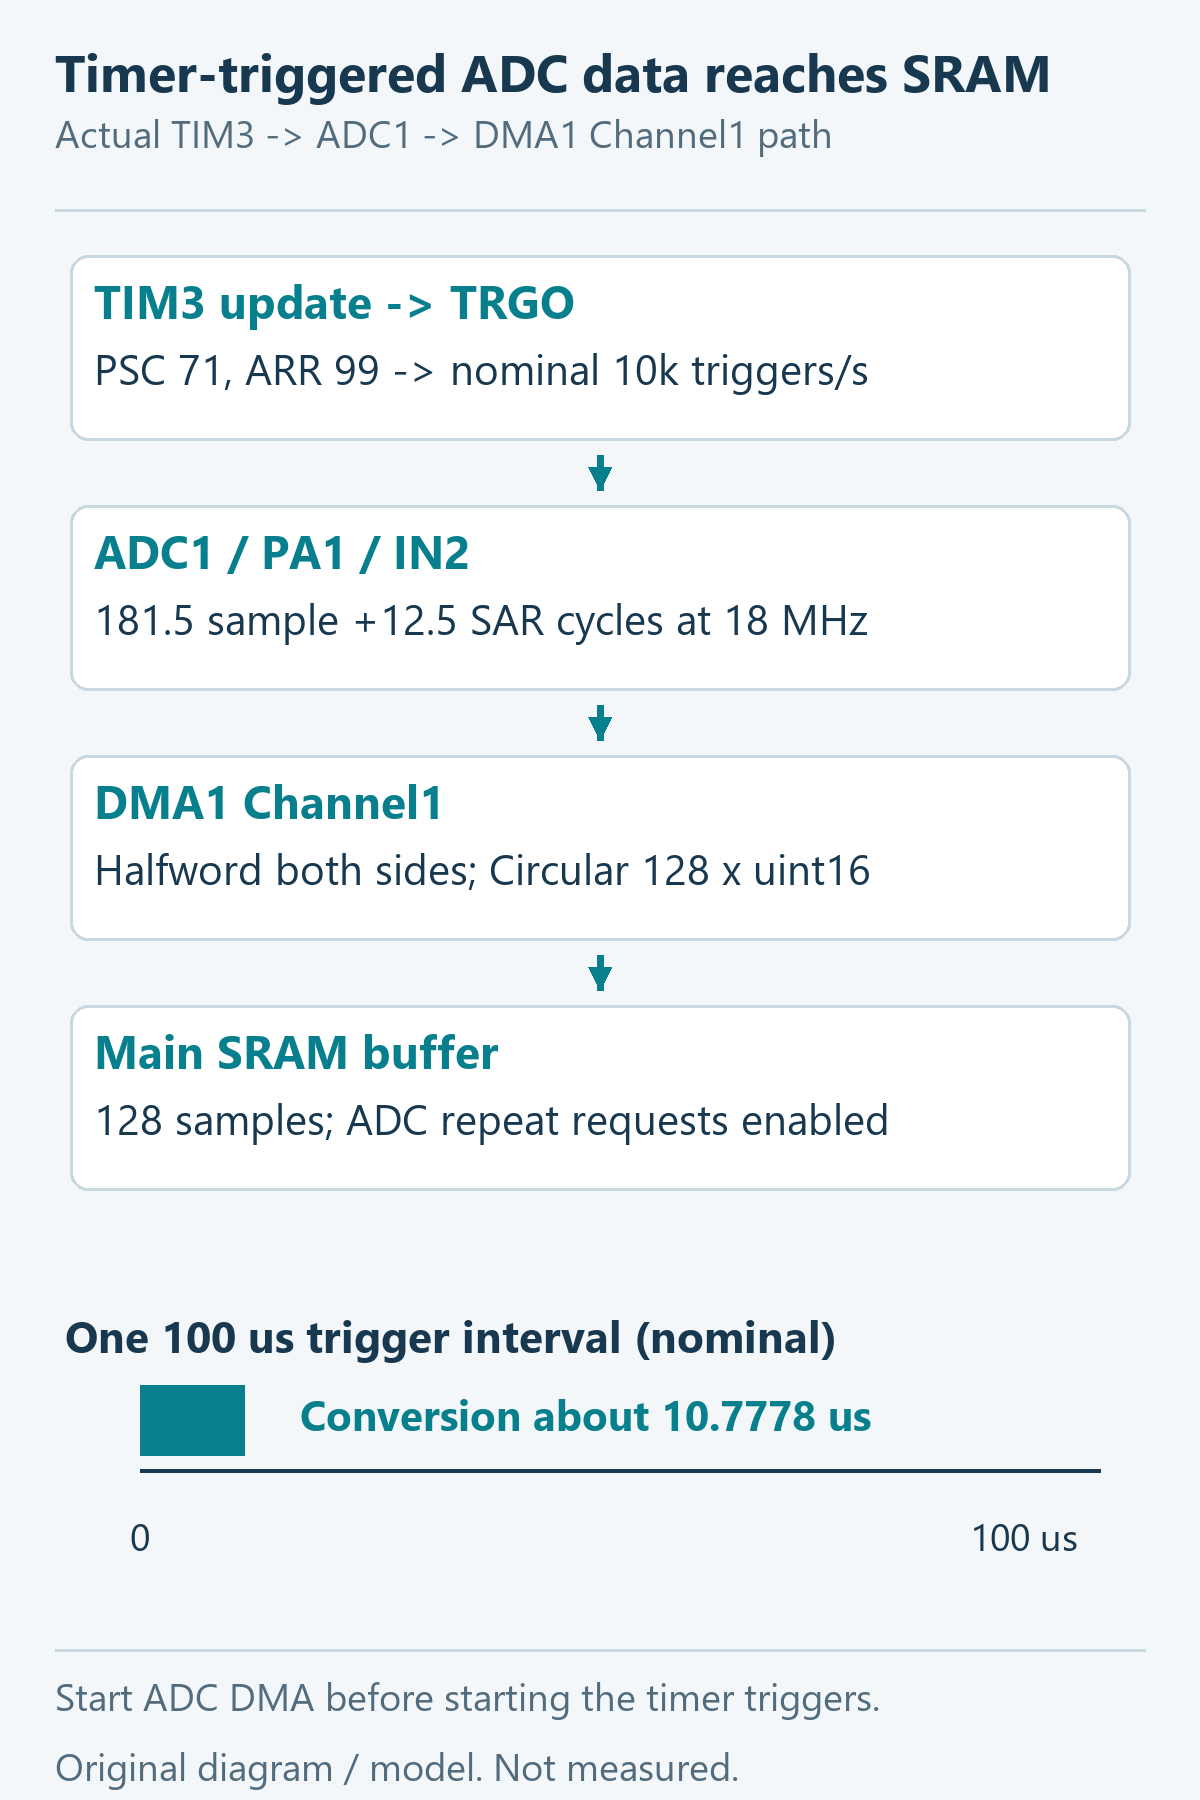
در مسیر کلاک انتخابشده، TIM3 با 72 MHz کار میکند: HSE=8 MHz، PLL×9 ، HCLK=72 MHz و APB1 با مقسم 2 روی 36 MHz است، ولی در مسیر کلاک APB1 همین تراشه، چون مقسم 2 است، کلاک این تایمر دو برابر PCLK1 ، یعنی 2×36 MHz=72 MHz میشود. این قاعده را بدون بررسی به همهٔ خانوادهها تعمیم ندهید. با PSC=71 و ARR=99 ، رویداد Update هر 100 µs تولید میشود.
T_trigger = 1 / 10000 = 100 µs
ADC1 یک کانال PA1/IN2 را با تفکیک 12 بیت و کلاک همگام AHB/4 ، یعنی 18 MHz میخواند. زمان نمونهبرداری 181.5 سیکل و بخش تبدیل 12.5 سیکل است. جمع اسمی آنها 194/18 MHz≈10.7778 µs است که از فاصلهٔ تریگر 100 µs کوتاهتر است. این محاسبه شامل راهاندازی اولیه، تأخیر مسیر تریگر و اثبات نشست ورودی برای هر منبع دلخواه نیست. امپدانس منبع و ولتاژ همچنان باید با درس قبل و DS9118 تطبیق داده شوند.
سه نرخ را با هم اشتباه نگیریم
بافر اصلی 128 خانهٔ uint16_t دارد. هر خانه یک نمونهٔ 12 بیتی راستچین را نگه میدارد. نصف بافر، 64 نمونه است؛ هر 6.4 ms یک نیمه آماده میشود و هر 12.8 ms یک دور کامل میشود.
| کمیت | مقدار اسمی | معنی |
|---|---|---|
| نرخ نمونه | 10000 S/s | هر 100 µs یک تبدیل |
| مجموع رخدادهای HT و TC | 156.25 رخداد/s | هر 64 نمونه یک مرز نیمبافر |
| رخداد HT بهتنهایی یا TC بهتنهایی | 78.125 رخداد/s | هر نوع، یکبار در هر دور 128 نمونه |
| پردازش هدف | 156.25 نیمه/s | پردازش هر دو نیمه بدون عقبماندن |
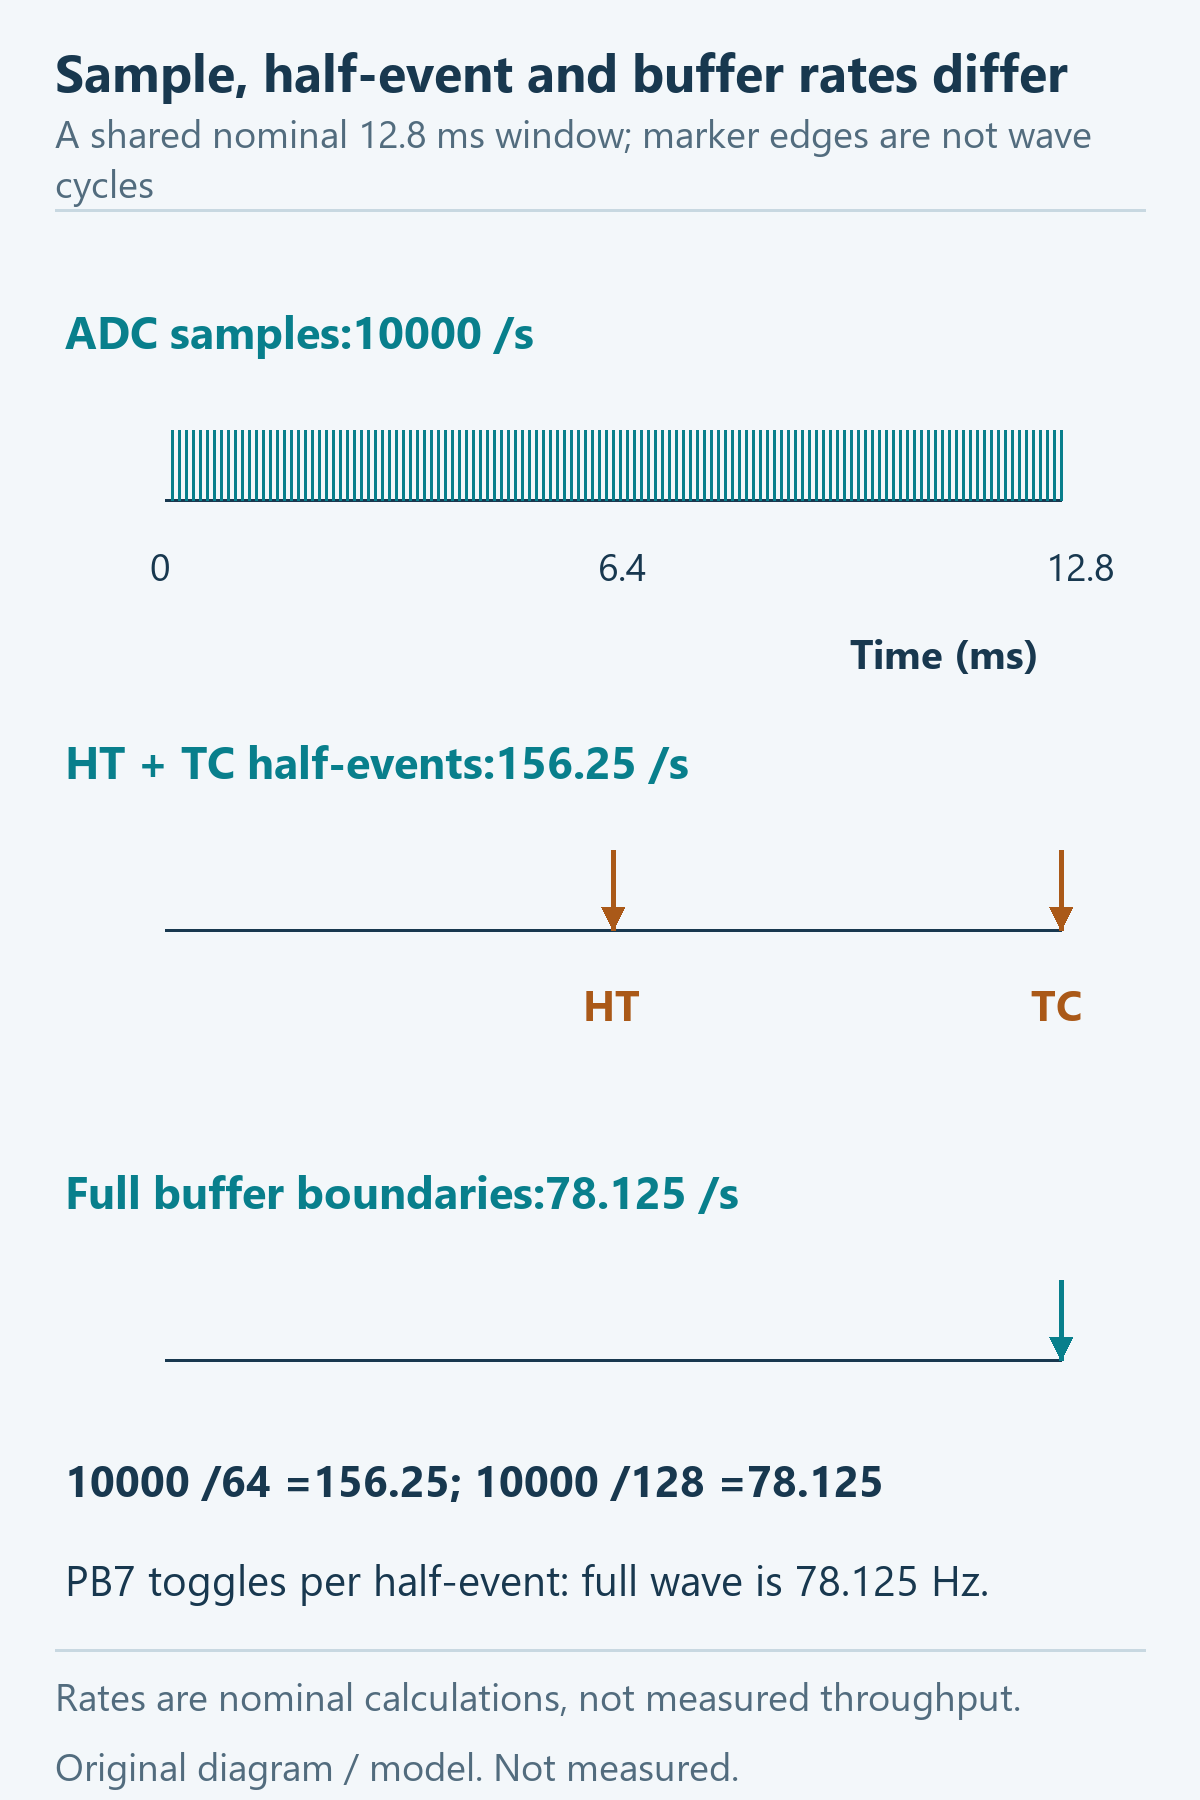
HT یا Half Transfer پایان نیمهٔ اول و TC یا Transfer Complete پایان نیمهٔ دوم است. مجموع این دو callback را «رخدادهای نیمبافر» مینامیم؛ HT بهتنهایی 156.25 بار در ثانیه نیست. نرخ واقعی پردازش از شمارندهٔ processed_halves و مدت مشاهده به دست میآید و در صورت خطا میتواند کمتر شود.
تنظیمات CubeMX و ترتیب راهاندازی
- PA1 را ADC1_IN2 در حالت آنالوگ قرار دهید؛ پایهٔ فیزیکی آن در LQFP48 عدد 11 است، نه لزوماً شمارهٔ 11 هدر برد. ورودی در محدودهٔ آنالوگ مجاز VDDA بماند؛ ورودی 5 V مستقیم مجاز فرض نشود.
- ADC1 را Single-ended، 12-bit، Right alignment، یک Rank و Sampling Time=181.5 cycles تنظیم کنید. Continuous Conversion خاموش، تریگر TIM3_TRGO با لبهٔ بالارونده و کلاک ADC برابر AHB/4 باشد.
- TIM3 را با PSC=71 و ARR=99 تنظیم و Master Output Trigger را Update انتخاب کنید. در tim.c تولیدشده باید sMasterConfig.MasterOutputTrigger=TIM_TRGO_UPDATE باشد؛ صرف نوشتهٔ گزینهای مشابه در IOC، اعمال تنظیم را ثابت نمیکند.
- برای ADC1 ، DMA1_Channel1 را Peripheral-to-memory با عرض Half-word در هر دو سمت، افزایش آدرس حافظه و Circular انتخاب کنید. DMA Continuous Requests در ADC روشن باشد. اولویت DMA در این پروژه High است.
- وقفهٔ DMA1 Channel1 و ADC1_2 را فعال کنید؛ اولویت هر دو در این پروژه 2 است. PB7 خروجی نشانگر مرز نیمبافر است. handlerهای تولیدشده باید به HAL_DMA_IRQHandler و HAL_ADC_IRQHandler متصل باشند.
در Normal، انتقال پس از تعداد تعیینشده تمام میشود و باید برای دریافت بعدی تصمیم گرفت؛ در Circular، آدرس پس از خانهٔ آخر به آغاز برمیگردد. Circular بهتنهایی مشکل مصرفکنندهٔ کند را حل نمیکند. خاموشبودن DMA Continuous Requests نیز با نیاز به درخواستهای پیوستهٔ این پروژه سازگار نیست.
ابتدا ADC در حالت غیرفعال کالیبره میشود؛ سپس HAL_ADC_Start_DMA مسیر دریافت را آماده میکند و در پایان تایمر شروع میشود. در غیر این صورت ممکن است تریگرهای اولیه پیش از آمادهشدن گیرنده برسند. قطعهٔ زیر از USER CODE 2 پروژهٔ اصلی است؛ همهٔ تعریفها، فایل IOC و توابع تولیدشده در دانلود قرار دارند.
__HAL_DBGMCU_FREEZE_TIM3();
  CoreDebug->DEMCR |= CoreDebug_DEMCR_TRCENA_Msk;
  if ((DWT->CTRL & DWT_CTRL_NOCYCCNT_Msk) != 0U) { Error_Handler(); }
  DWT->CYCCNT = 0U;
  DWT->CTRL |= DWT_CTRL_CYCCNTENA_Msk;
  __DSB(); __ISB();
  if (HAL_ADCEx_Calibration_Start(&hadc1, ADC_SINGLE_ENDED) != HAL_OK) { Error_Handler(); }
  if (HAL_ADC_Start_DMA(&hadc1, (uint32_t *)(uintptr_t)adc_samples, 128U) != HAL_OK)
  { Error_Handler(); }
  __HAL_TIM_SET_COUNTER(&htim3, 0U);
  __HAL_TIM_CLEAR_FLAG(&htim3, TIM_FLAG_UPDATE);
  observation_start = HAL_GetTick();
  if (HAL_TIM_Base_Start(&htim3) != HAL_OK) { Error_Handler(); }
تبدیل اشارهگر adc_samples به uint32_t* برای امضای API است و عرض انتقال DMA را Word نمیکند. تنظیم سختافزاری این پروژه در هر دو سمت Half-word است. آرایهٔ 256 بایتی و کپی خصوصی 128 بایتی در SRAM اصلی قرار دارند؛ DMA به CCM دسترسی ندارد. این Cortex-M4 کش دادهٔ F7/H7 ندارد، پس کد نگهداری D-cache از آن خانوادهها را به اینجا کپی نکنید.
DMA مینویسد؛ برنامه کدام نیمه را بخواند؟
وقتی نیمهٔ اول پر شد، DMA به نیمهٔ دوم میرود. برنامه میتواند نیمهٔ اول را بخواند تا پیش از بازگشت DMA تمام شود. برای نیمهٔ دوم نیز همین روال تکرار میشود. این روش، تقسیم نرمافزاری یک بافر چرخشی است؛ قابلیت Double Buffer سختافزاری که این DMA ندارد، نیست.
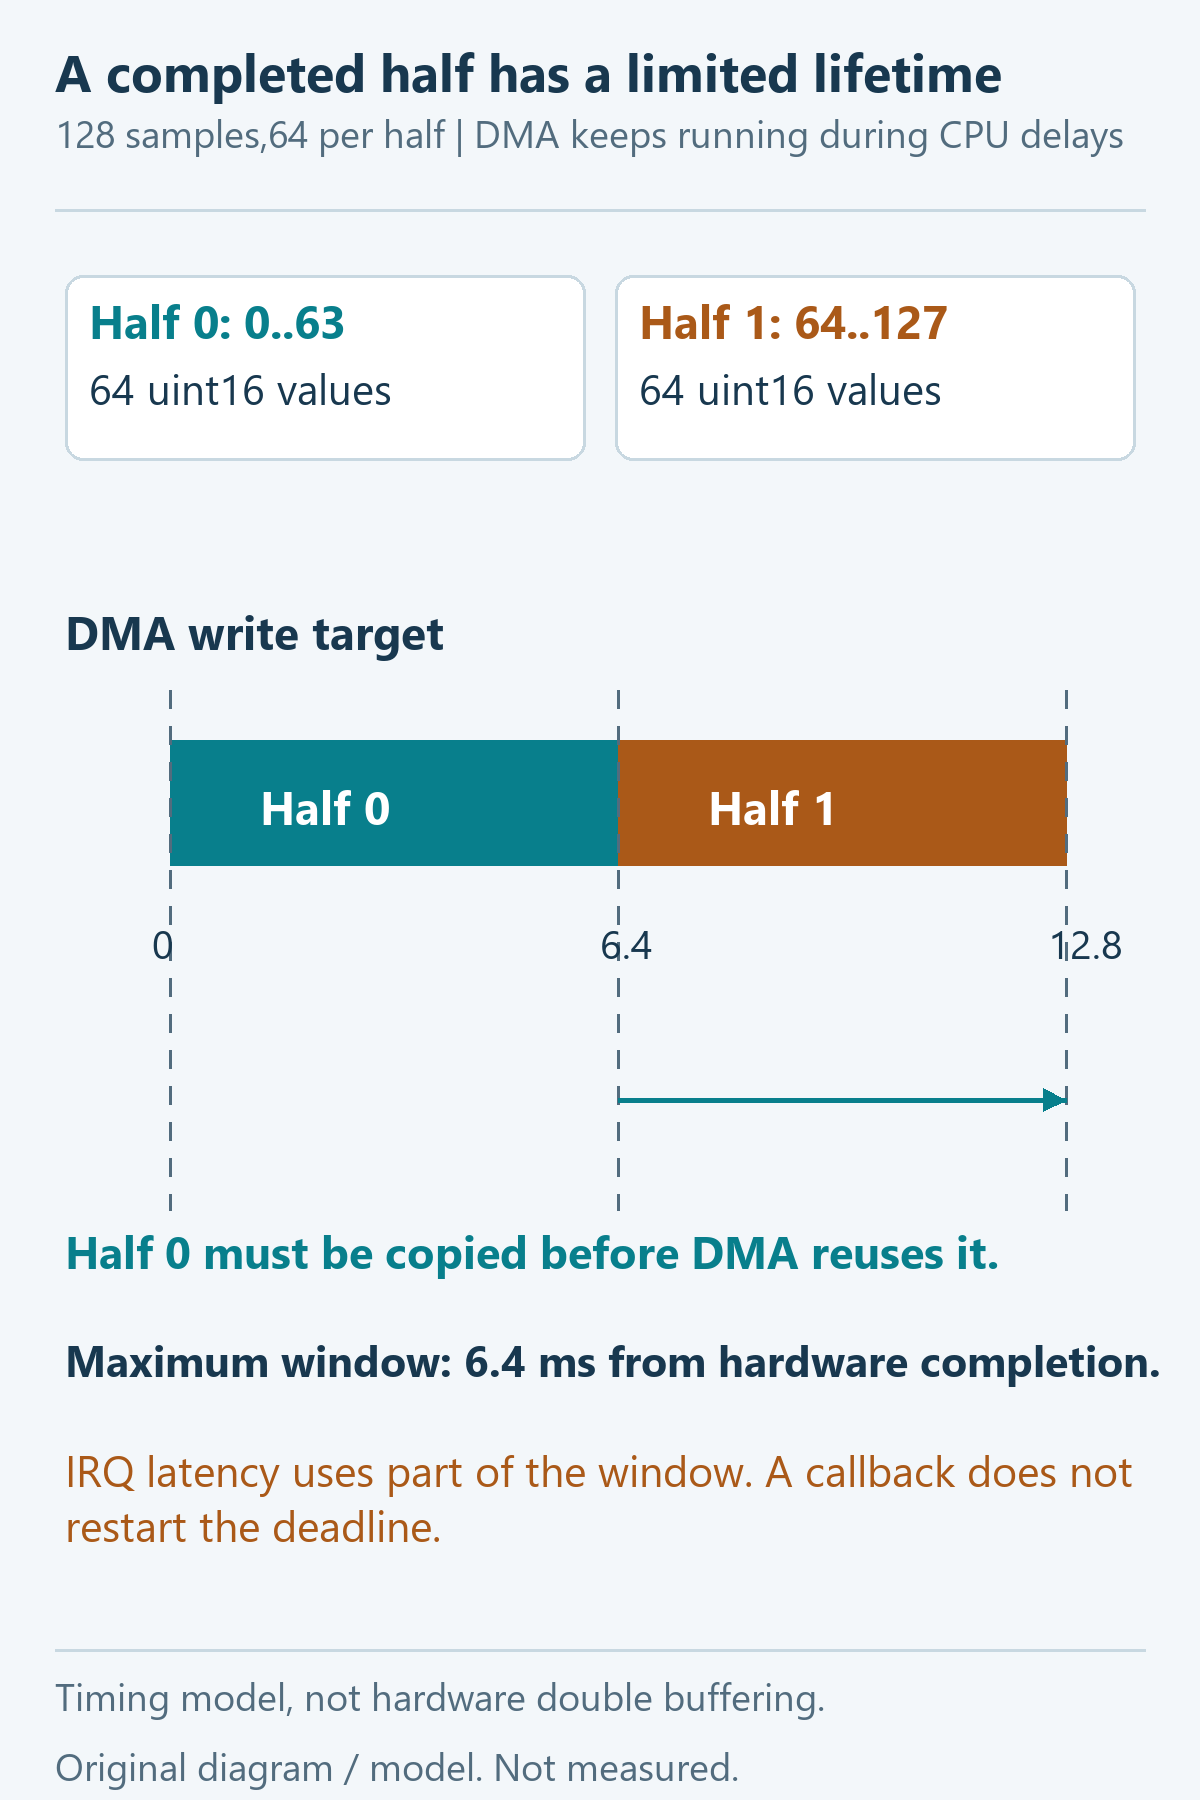
در نرخ اسمی این درس، فاصلهٔ پایان یک نیمه تا شروع بازنویسی آن 6.4 ms است. تأخیر ورود به وقفه، رسیدگی به کارهای دیگر و زمان کپی از این بودجه کم میشود. بنابراین «از وقتی برنامه متوجه شد، 6.4 ms فرصت دارد» تعبیر درستی نیست.
چرا یک پرچم ready کافی نیست؟
اگر دو نیمه آماده شوند و برنامه هنوز فقط یک پرچم یکبیتی ببیند، ممکن است رویداد قبلی گم شود. خاموشکردن وقفهها هم DMA را متوقف نمیکند؛ سختافزار همچنان در حافظه مینویسد. volatile فقط به دسترسی کامپایلر کمک میکند و مالکیت یا سالمبودن یک بلوک را تضمین نمیکند.
callbackهای پروژه فقط شمارهٔ نیمه، شمارهٔ توالی مرزها و شمارندهها را ثبت میکنند و PB7 را معکوس میکنند. حلقهٔ اصلی داده را به owned_copy منتقل میکند و پس از کنترل اعتبار، مجموع، کمینه و بیشینهٔ همین کپی خصوصی را حساب میکند. آن کپی دیگر هدف DMA نیست.
static void PublishBoundary(uint32_t half)
{
  ready_half = half;
  __DMB();
  boundary_sequence++;
  HAL_GPIO_TogglePin(BLOCK_MARKER_GPIO_Port, BLOCK_MARKER_Pin);
}
اتصال تابع کمکی به callbackهای استاندارد HAL، در USER CODE 4 چنین است. فقط callback تکمیل دور، complete_buffers را افزایش میدهد:
void HAL_ADC_ConvHalfCpltCallback(ADC_HandleTypeDef *hadc)
{
  if (hadc->Instance == ADC1) { PublishBoundary(0U); }
}

void HAL_ADC_ConvCpltCallback(ADC_HandleTypeDef *hadc)
{
  if (hadc->Instance == ADC1)
  {
    complete_buffers++;
    PublishBoundary(1U);
  }
}کنترلهای قبل و بعد از کپی
در پروژه، اختلاف شمارهٔ توالی باید دقیقاً 1 باشد. سپس CNDTR، تعداد انتقالهای باقیماندهٔ DMA، نشان میدهد نیمهٔ مورد نظر فعلاً هدف نوشتن نیست. شمارندهٔ سیکل هسته DWT نیز مدت کپی را میسنجد. بودجه از انتقالهای باقیمانده تا مرز بعدی محاسبه و یک دورهٔ نمونه حاشیه کم میشود. پس از کپی، شمارهٔ توالی، موقعیت DMA و زمان دوباره بررسی میشوند؛ دادهٔ مشکوک منتشر نمیشود.
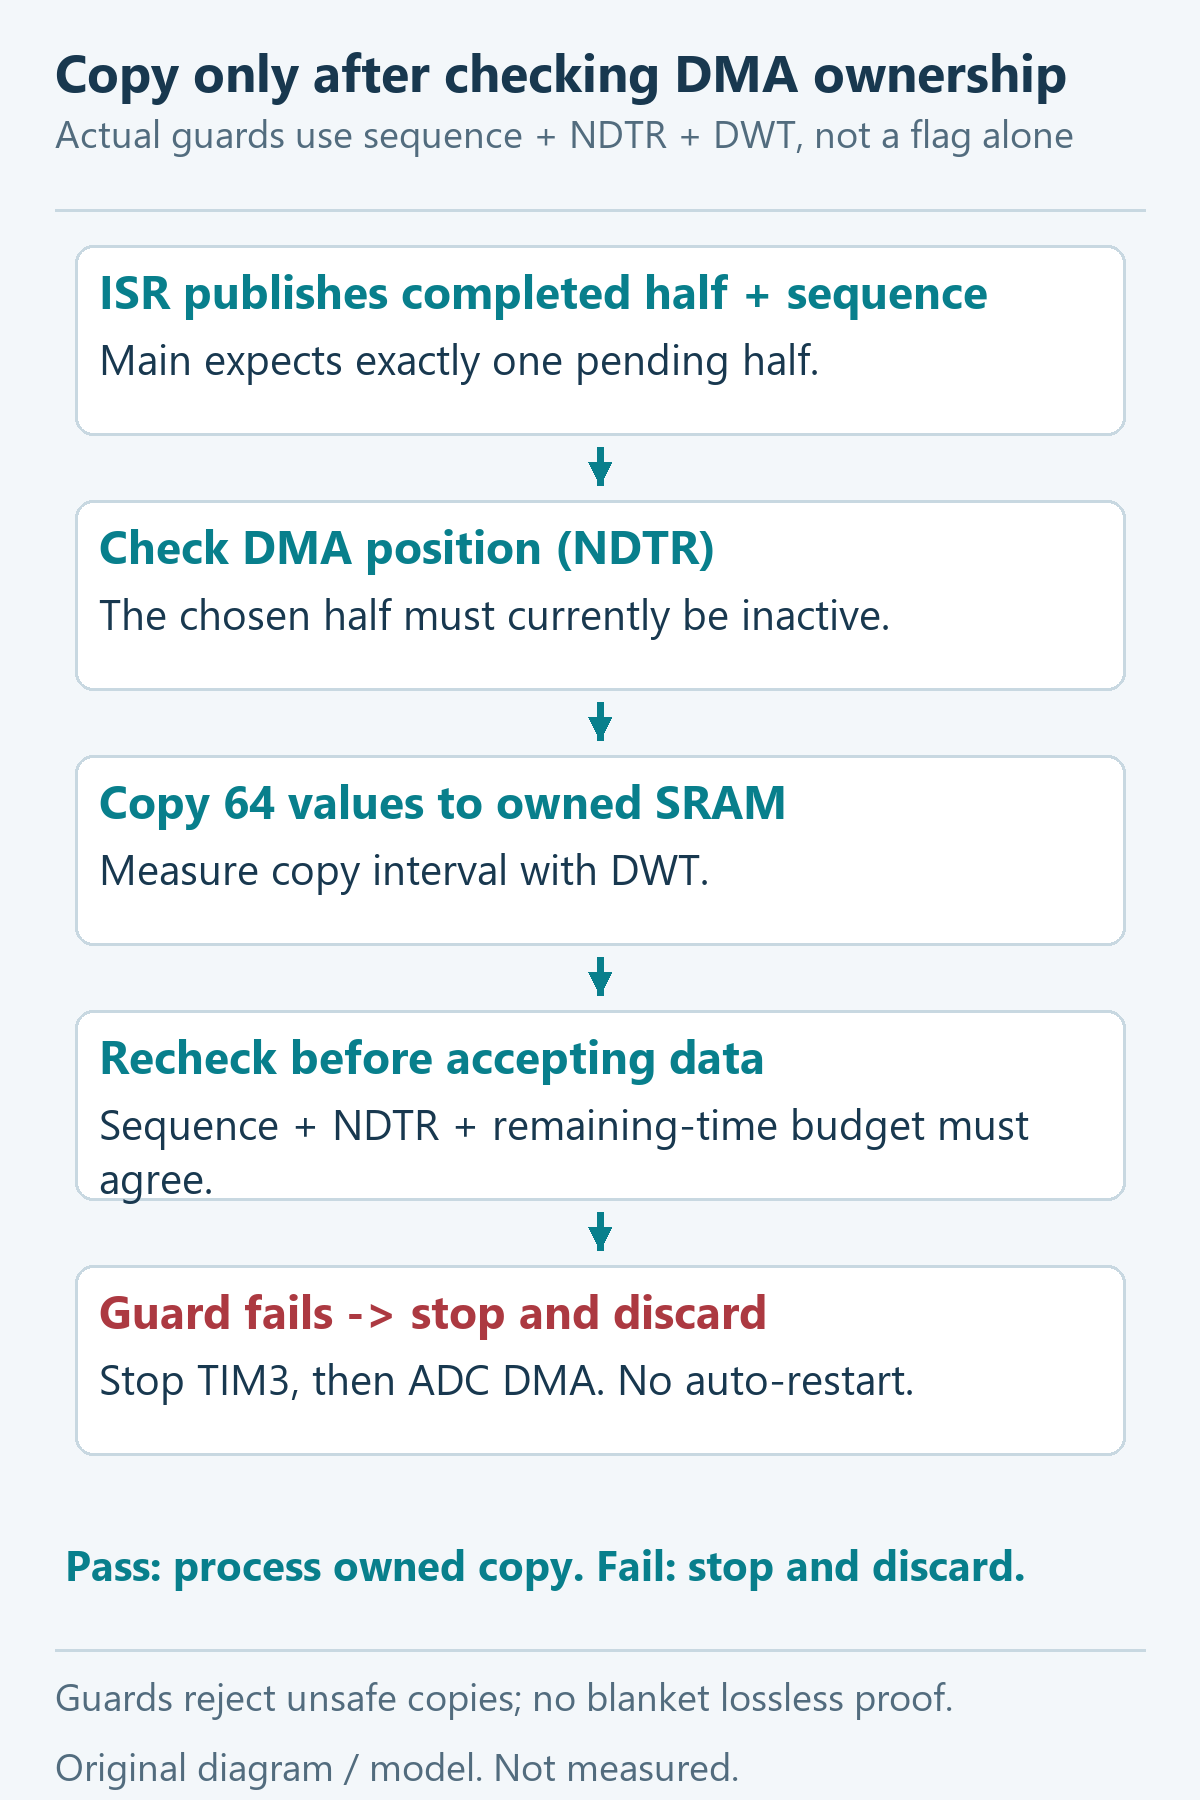
کد زیر عین تابع ServiceCompletedHalf در USER CODE 0 است. HalfIsInactive، SetFault و متغیرها در پروژه تعریف شدهاند. هر دورهٔ نمونه در HCLK=72 MHz برابر 7200 سیکل است؛ با تغییر کلاک یا نرخ نمونه، این ثابت و تحلیل زمان باید دوباره محاسبه شوند.
static void ServiceCompletedHalf(void)
{
  uint32_t saved = __get_PRIMASK();
  __disable_irq();
  uint32_t sequence = boundary_sequence;
  uint32_t half = ready_half;
  __set_PRIMASK(saved);
  if (sequence == consumed_sequence) { return; }
  if ((uint32_t)(sequence - consumed_sequence) != 1U)
  {
    late_blocks++;
    SetFault(1U);
    return;
  }

  uint32_t c0 = DWT->CYCCNT;
  uint32_t n0 = __HAL_DMA_GET_COUNTER(hadc1.DMA_Handle);
  if (HalfIsInactive(half, n0) == 0U) { late_blocks++; SetFault(1U); return; }
  uint32_t transfers_to_boundary = half == 0U ? n0 : n0 - 64U;
  if (transfers_to_boundary <= 1U) { late_blocks++; SetFault(1U); return; }
  /* One conversion may finish immediately. Leave one sample period margin. */
  uint32_t budget_cycles = (transfers_to_boundary - 1U) * SAMPLE_PERIOD_CORE_CYCLES;
  for (uint32_t i = 0U; i < HALF_SAMPLES; ++i)
  {
    owned_copy[i] = adc_samples[half * HALF_SAMPLES + i];
  }
  __DMB();
  uint32_t elapsed = (uint32_t)(DWT->CYCCNT - c0);
  uint32_t n1 = __HAL_DMA_GET_COUNTER(hadc1.DMA_Handle);
  if (elapsed >= budget_cycles || boundary_sequence != sequence ||
      HalfIsInactive(half, n1) == 0U || fault_bits != 0U)
  {
    late_blocks++;
    SetFault(1U);
    return; /* Never publish a copy whose ownership checks failed. */
  }

  consumed_sequence = sequence;
  uint32_t sum = 0U, minimum = 4095U, maximum = 0U;
  for (uint32_t i = 0U; i < HALF_SAMPLES; ++i)
  {
    uint32_t value = owned_copy[i];
    sum += value;
    if (value < minimum) { minimum = value; }
    if (value > maximum) { maximum = value; }
  }
  block_sum = sum;
  block_minimum = minimum;
  block_maximum = maximum;
  processed_halves++;
}
این کنترلها تحت فرض کلاک مشخص، اجرای آزاد، رسیدگی بهموقع به IRQ/DMA و نبود نویسندهٔ دیگر طراحی شدهاند. شمارندهٔ نرمافزاری، مدرک تشخیص همهٔ رویدادهای فیزیکی نیست؛ چند رخداد میتوانند هنگام وقفهٔ طولانی با هم ادغام شوند. توقف Debugger، زمانهای نامحدود و تغییر کلاک، اعتبار این تحلیل را از بین میبرند. ادعای دریافت بیاتلاف در هر شرایطی نداریم.
سه نوع خطا و واکنش واقعی برنامه
Overrun در ADC یعنی نتیجهٔ جدید پیش از رسیدگی به نتیجهٔ قبلی برسد و وضعیت OVR ایجاد شود. بازنویسی بافر یعنی DMA دادهٔ جدید را روی نیمهای بگذارد که برنامه هنوز مصرف نکرده است. ممکن است ADC هیچ OVR نداشته باشد ولی برنامه بافر را از دست بدهد، چون DMA رجیستر ADC را بهموقع خالی کرده است. عقبماندن پردازش هم کمبود سرعت مصرفکننده نسبت به جریان ورودی است.
در callback خطای ADC، خطاهای HAL، OVR و DMA ثبت میشوند. در خطای مالکیت یا مهلت، late_blocks افزایش مییابد. سپس حلقهٔ اصلی TIM3 و ADC/DMA را متوقف و وضعیت توقف را بررسی میکند. برنامه بهطور خودکار از سر نمیگیرد و دادهٔ ناقص را «بازیابیشده» معرفی نمیکند. SetFault در یک ناحیهٔ بحرانی کوتاه، بیت خطا را ثبت میکند.
نسخهٔ مقایسهای ADC با وقفه
پوشهٔ دانلود، یک پروژهٔ جدا با همان تریگر TIM3 و ADC دارد که بهجای DMA از HAL_ADC_Start_IT استفاده میکند. در handler همین HAL، غیرفعالکردن خودکار وقفهٔ پایان توالی در این مسیر، شرط شروع نرمافزاری و Continuous خاموش دارد؛ پروژه تریگر خارجی TIM3 دارد و آن شرط برقرار نیست. پس برای هر نمونه Start_IT دوباره فراخوانی نمیشود و زمان شروع تبدیل همچنان با تایمر تعیین میشود؛ این نسخه Polling یا شروع نرمافزاری هر نمونه نیست. callback کوتاه زیر آخرین مقدار را نگه میدارد و شمارنده را افزایش میدهد.
void HAL_ADC_ConvCpltCallback(ADC_HandleTypeDef *hadc)
{
  if (hadc->Instance == ADC1)
  {
    adc_last_sample = HAL_ADC_GetValue(hadc);
    adc_interrupt_samples++;
    HAL_GPIO_TogglePin(BLOCK_MARKER_GPIO_Port, BLOCK_MARKER_Pin);
  }
}
انتظار اسمی 10000 callback در ثانیه است، در حالی که نسخهٔ DMA مجموعاً 156.25 callback بلوکی دارد. این مقایسه تعداد سرویسهاست، نه اندازهگیری بار CPU. نسخهٔ IT صف همهٔ نمونهها ندارد و فقط آخرین مقدار را نگه میدارد. بالا بردن نرخ میتواند بودجهٔ ISR را مصرف و باعث ازدسترفتن داده شود؛ سقف واقعی باید با زمانسنجی و شمارش خطا تعیین شود.
آزمایش پیشنهادی و محاسبهٔ نتیجهٔ مورد انتظار
برای ورودی ساده، پتانسیومتر 10kΩ بین تغذیهٔ مناسب 3.3 V برد و GND و لغزنده روی PA1 قابل استفاده است، به شرط بررسی اینکه ولتاژ ورودی از محدودهٔ VDDA خارج نشود. زمین منبع خارجی مشترک باشد. PB7 پایهٔ فیزیکی 43 است؛ از برچسب PB7 روی برد استفاده کنید، نه فرض شمارهٔ هدر. TRGO داخلی است و برای اتصال تایمر به ADC سیم خارجی نمیخواهد.
- پس از ساخت و فلش توسط خودتان، برنامهٔ اصلی را آزاد اجرا کنید. fault_bits، stopped، processed_halves و complete_buffers را بررسی و شرایط مشاهده را ثبت کنید. متوقفکردن پردازنده در میانهٔ آزمایش، شاهد سالمماندن جریان نیست.
- در صورت داشتن اسیلوسکوپ، PB7 را با زمین مشترک مشاهده کنید. در نسخهٔ DMA هر 6.4 ms انتظار تغییر سطح داریم؛ یک موج کامل 12.8 ms و فرکانس آن 78.125 Hz است. در نسخهٔ IT که در هر نمونه Toggle میکند، انتظار اسمی موج 5 kHz داریم. اینها پیشبینیاند، نه دادهٔ ثبتشده.
- شمارندهٔ complete_buffers را در مدت واقعی observation_ms بخوانید. برنامه در اولین رسیدن حلقه به حداقل 10000 ms، شمارنده و مدت را ثبت میکند؛ پنجره الزاماً دقیقاً 10s نیست. تعداد callback، شمارش تضمینی همهٔ تبدیلهای سختافزاری نیست.
- نسخهٔ جداگانهٔ gebrabit_lesson23_late در حلقهٔ اصلی 20 ms تأخیر دارد. انتظار طراحی، تشخیص عقبماندن و توقف محافظهکارانه پیش از انتشار کپی نامعتبر است؛ این رفتار باید روی برد تأیید شود، نه اینکه وقوع OVR در ADC حتماً فرض شود.

100000 = 781 × 128 + 32
Ideal full buffers = 781; remaining samples = 32
خطای کریستال، تأخیر مشاهده و توقف بر اثر خطا بر مقایسهٔ واقعی اثر دارند. برای اثبات نرخ و سلامت، زمان مستقل، شمارندهها و خطاها را با هم ارزیابی کنید؛ فقط عدد 781 ، سلامت کل جریان را ثابت نمیکند.
عیبیابی، ساخت و محدودیت اعتبارسنجی
| نشانه | بررسی |
|---|---|
| هیچ نمونهای نمیرسد | شروع TIM3 ، TRGO=Update در tim.c، منبع T3_TRGO در adc.c و ترتیب Start_ADC سپس Start_Timer را بررسی کنید. |
| دریافت ادامه ندارد | Circular، DMA Continuous Requests، اتصال IRQها و fault_bits را ببینید. |
| callback هست ولی داده غلط است | عرض Half-word، اندازهٔ آرایه، محل SRAM، Rank و PA1/IN2 را تطبیق دهید. |
| late_blocks زیاد میشود | کار سنگین/تأخیر حلقه، فاصلهٔ رسیدگی و کنترل مالکیت را بررسی کنید؛ فقط بزرگکردن بافر درمان قطعی نیست. |
| OVR صفر است اما بلوک از دست میرود | بازنویسی SRAM با OVR رجیستر ADC متفاوت است؛ شمارندههای توالی و مهلت را جدا بررسی کنید. |
هر 3 پروژه با خروجی واقعی CubeMX 6.14 ، بستهٔ CubeF3 1.11.6 و GCC 13.2.1 در Debug با -O0 ، -g3 ، -Wall و -Werror از نو ساخته شدهاند؛ نسخهٔ DMA از 19384 B Flash و 2264 B RAM، نسخهٔ تأخیر عمدی از 19460 B و 2264 B و نسخهٔ IT از 17080 B و 1760 B استفاده/رزرو میکند. RAM گزارش لینک است و بیشینهٔ پشتهٔ اجرا نیست. مدل همراه 15 بررسی عددی و منطقی را گذرانده است؛ گزارش نهایی در فایل همراه است. مدل عددی/منطقی، جای آزمون سختافزاری نیست. فلشکردن، GUI، اندازهگیری نرخ، زمان CPU، ولتاژ و اسیلوسکوپ انجام نشدهاند؛ کاربرگ آزمایش با خانههای ثبت نتیجه در دانلود موجود است.
خودآزمایی با پاسخ
پرسش 1: تایمر چه چیزی را منظم میکند؟
پاسخ: زمان صدور تریگر شروع تبدیل را، بر پایهٔ کلاک؛ نه زمان پردازش حلقه و نه صحت مطلق ولتاژ را.
پرسش 2: چرا Continuous Conversion خاموش است؟
پاسخ: تا تبدیلها به تریگرهای TIM3 وابسته بمانند؛ در حالت پیوسته، تبدیلهای بعدی میتوانند خودکار ادامه پیدا کنند.
پرسش 3: 128 نمونه در 10 kS/s چه زمانی پر میشوند؟
پاسخ: در مدل اسمی 12.8 ms؛ یک نیمهٔ 64 نمونهای هر 6.4 ms آماده میشود.
پرسش 4: چرا PRIMASK یا volatile بافر DMA را ثابت نمیکنند؟
پاسخ: PRIMASK رسیدگی به وقفهها را محدود میکند، نه نوشتن DMA؛ volatile نیز قفل یا مالکیت بافر ایجاد نمیکند.
پرسش 5: آیا OVR=0 ثابت میکند برنامه همهٔ بلوکها را خوانده است؟
پاسخ: خیر؛ DMA میتواند رجیستر ADC را بهموقع بخواند ولی نیمهٔ مصرفنشدهٔ SRAM را دوباره بنویسد.
پرسش 6: Toggle در هر مرز نیمبافر چه فرکانس موجی میدهد؟
پاسخ: دو Toggle یک دوره میسازند؛ 156.25 تغییر سطح در ثانیه، موج اسمی 78.125 Hz میدهد.
تمرین
- برای نرخ 20 kS/s و همان بافر 128 تایی، مهلت نیمبافر و مجموع نرخ callback را حساب کنید. پاسخ: 3.2 ms و 312.5 رخداد/s؛ سپس زمان تبدیل و بودجهٔ جدید را دوباره بررسی کنید.
- دو کانال را در یک توالی DMA قرار دهید. ترتیب خانههای آرایه، نرخ هر کانال و اینکه یک تریگر چند تبدیل ایجاد میکند را مشخص کنید؛ آنها را نمونهبرداری همزمان فرض نکنید. قبل از اجرا، اندازهٔ بافر و مرز نیمهها را متناسب با تعداد Rankها انتخاب کنید.
- برای ارسال 10000 نمونهٔ 16 بیتی در ثانیه روی UART با 8N1 ، حداقل نظری 20000 بایت/s و 200000 بیت/s است. سربار پیام و حاشیه را اضافه کنید و توضیح دهید چرا 115200baud کافی نیست. صف خروجی و سیاست مواجهه با کندشدن گیرنده را نیز طراحی کنید.
منابع فنی
مبنای مشخصات تراشه DS9118 Rev14 و مبنای رفتار واحدها RM0316 است. رفتار HAL با سورس نسخهٔ 953955a و اتصال برد با شماتیک GB100ST V2.0 تطبیق داده شده است. برای ملاحظات ورودی، منبع و دقت ADC، AN2834 Rev10 را ببینید.
دانلود پروژه و فایلهای همراه درس 23
داخل ZIP، سورس کامل و IOC، خروجی واقعی ELF/MAP و گزارش ساخت، محاسبات قابل تکرار، کاربرگ آزمایش و 6 تصویر با اسکریپت قابل ویرایش قرار دارد. ابتدا بسته را استخراج و README را بخوانید.
این پیوند دانلود به نسخهٔ مشخص همراه مقاله متصل است. ساخت موفق برنامه و مدل محاسباتی، به معنی انجام آزمایش روی برد نیست.